R Markdown ve Quarto Karşılaştırması: Hangisi Tercih Edilmeli?
.Rmd ve .qmd farkı, output ve format alanları, çoklu dil desteği, yayın biçimleri, beş adımlı geçiş planı ve karar kontrol listesi.
- Araçlar
Veri analizi, sosyal medya, görselleştirme ve teknoloji üzerine yazdığım yazılarda, öğrendiklerimi ve deneyimlerimi paylaşıyorum.
Daha iyi sorular,
daha iyi analizler,
daha parlak yarınlar.
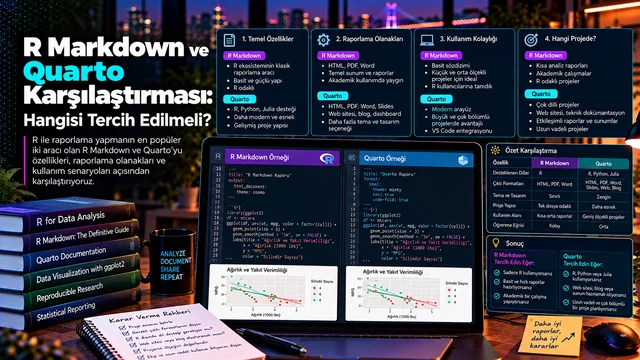
.Rmd ve .qmd farkı, output ve format alanları, çoklu dil desteği, yayın biçimleri, beş adımlı geçiş planı ve karar kontrol listesi.
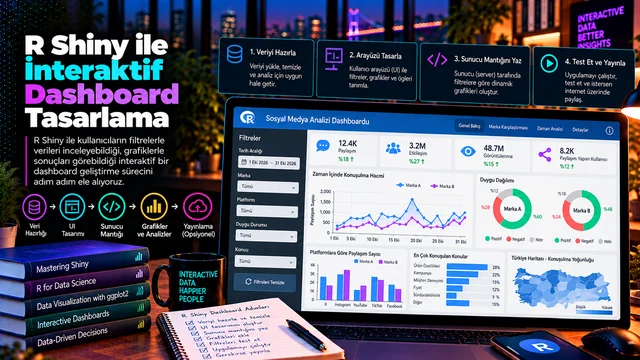
UI ve server ayrımı, reactive() ile tek kaynaktan besleme, .data[[ ]] ile dinamik eksen seçimi, validate(need()) ile boş durum, modüller ve dağıtım kontrol listesi.
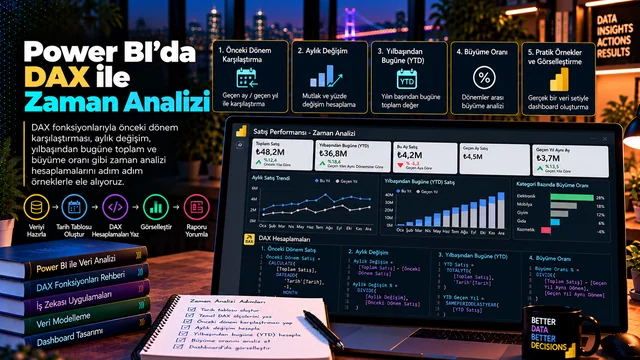
Tarih tablosu kurulumu, DATEADD ve SAMEPERIODLASTYEAR, DIVIDE ile güvenli bölme, TOTALYTD ve mali yıl, filtre bağlamı ve sessizce yanlış sonuç üreten yaygın hatalar.
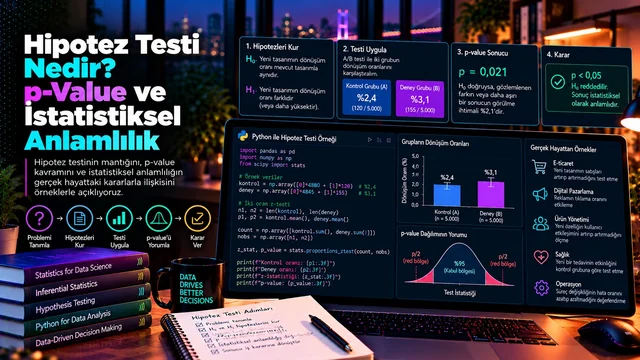
H₀ ve H₁ kurmaktan p-value'nun üç yaygın yanlış okumasına, Tip I-II hata ve test gücünden istatistiksel anlamlılıkla pratik önem ayrımına kadar.
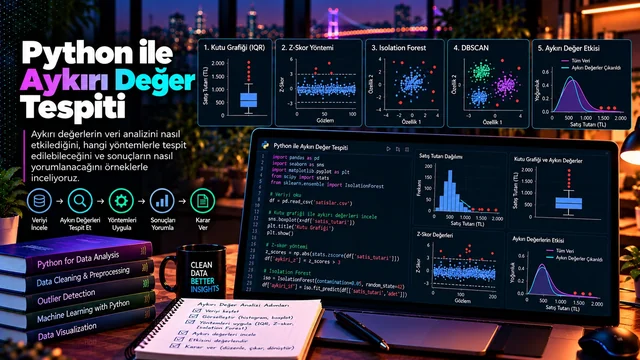
IQR ve Tukey sınırları, Z-skorunun maskeleme sorunu, MAD ile sağlam tarama, Isolation Forest ile çok değişkenli tespit ve yöntem seçim tablosu.
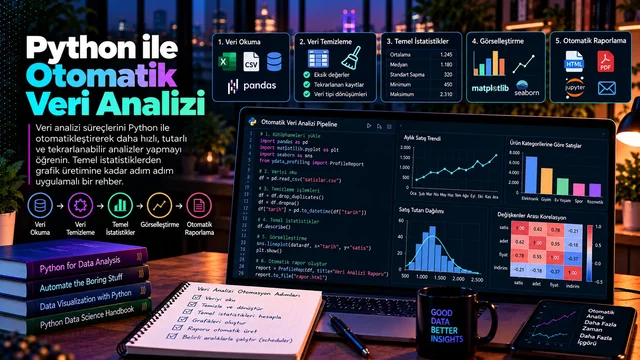
Şema kontrolünden kalite profiline, eksik değer kararlarından gruplu analize ve Excel raporuna kadar tekrarlanabilir bir pandas iş akışı.
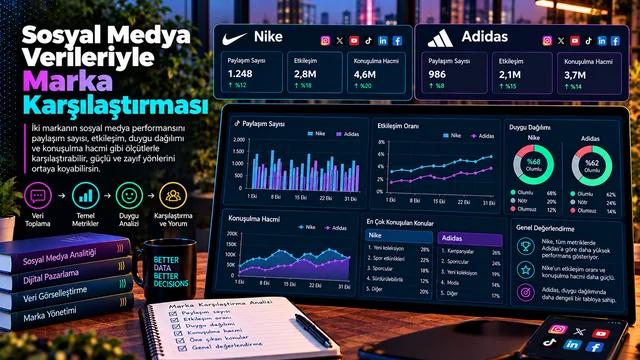
Adil kapsam kurmak, erişim ve takipçi başına oran farkı, duygu etiketlerinin güven sınırı, konuşulma payının izleme kapsamına duyarlılığı ve ölçüt yorum tablosu.
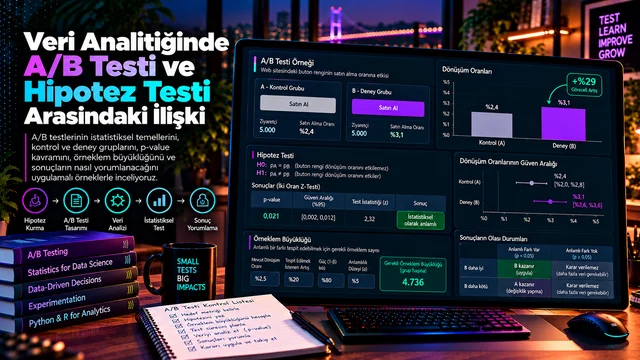
H₀ ve H₁, Tip I/II hata, p-value'nun en sık yapılan iki yanlış yorumu, mutlak fark ile göreli artış, örneklem büyüklüğü ve Python ile iki oran z-testi.
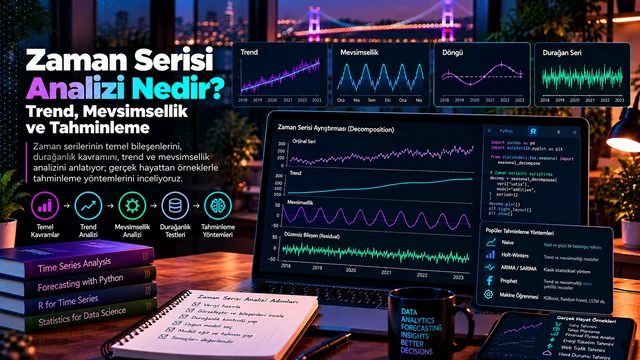
STL ile ayrıştırma, durağanlık ve fark alma, naif baseline'dan SARIMA'ya yöntem karşılaştırması, MAE/RMSE/MAPE ve zaman serilerinde doğrulamanın neden farklı olduğu.
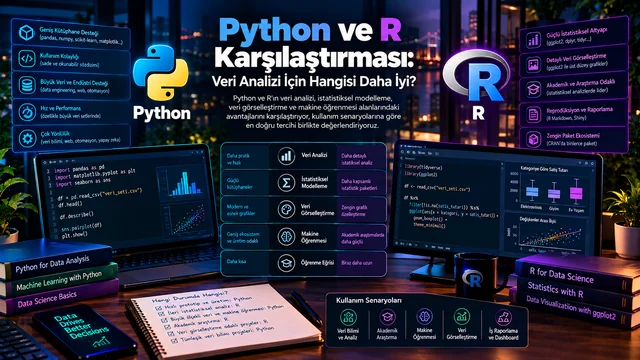
Aynı analizin pandas ve dplyr karşılığı, statsmodels ile lm(), ggplot2 ile seaborn, performans gerçekleri ve senaryoya göre karar tablosu.
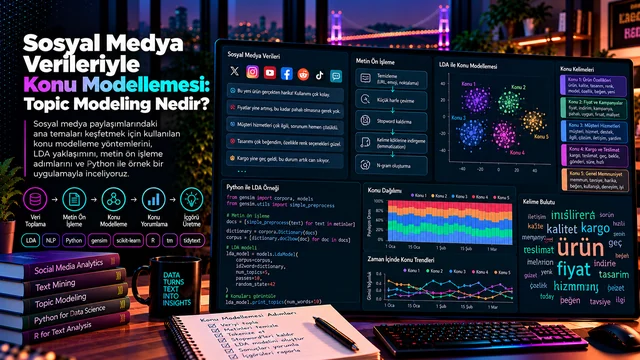
LDA'nın iki temel dağılımı, Türkçe metin ön işlemenin tuzakları, konu sayısı seçimi, Python ve R uygulamaları, model kalitesini değerlendirme ve LDA'nın sınırları.
Eksik değerleri yönetme, filtreleme, sütun dönüştürme, yinelenen kayıtları kontrol etme, tidyr ile uzun/geniş form arasında geçiş ve anahtarları doğrulayarak tablo birleştirme.
Taban oran %73,5 olan bir veride doğruluk neden işe yaramaz? Üç model, eşik taraması, odds oranları ve en riskli %10'da 2,85 kat isabet.
Serinin sonuncusu: ölçekleme, elbow ve siluet ile k seçimi, küme profilleri, bağlantı yöntemlerinin karşılaştırılması ve PCA ile iki boyuta inmek.
Dört algoritma, tek veri, tek test seti: confusion matrix'ten AUC'ye karşılaştırma ve basit modellerin topluluk yöntemlerini neden geçtiği.
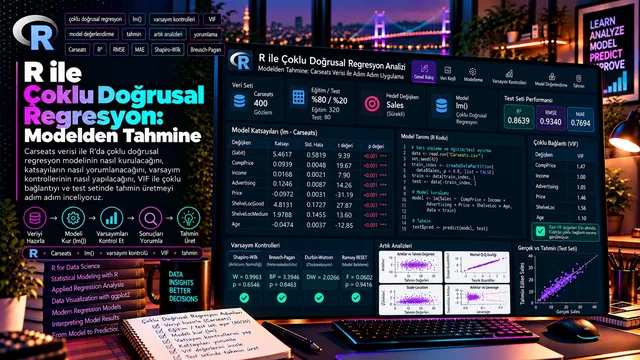
Serinin ikincisi: lm() ile model, katsayı ve referans kategori yorumu, dört varsayımın kontrolü, VIF ve test setinde RMSE / R² değerlendirmesi.
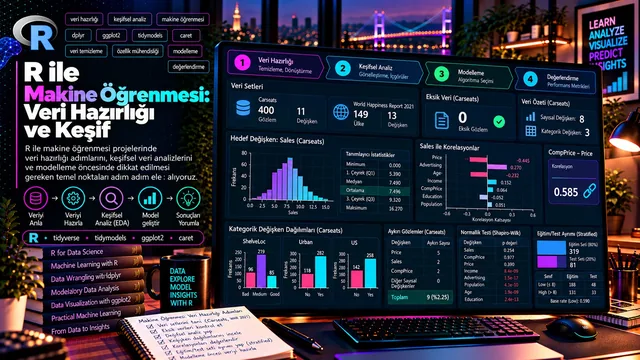
Dört bölümlük serinin ilki: Carseats ve World Happiness verileriyle eksik gözlem, dağılım, normallik ve tabakalı eğitim-test ayrımı.
YAML, chunk seçenekleri, parametreli raporlama ve rmarkdown::render ile otomasyon: analizi bir kez tasarlayıp raporu güvenilir biçimde yeniden üretmek.
UI ve server, reaktif programlama, çalışan bir satış dashboard'u, performans ve yayınlama: R analizini etkileşimli bir ürüne dönüştürmenin yolu.
Bileşenlere ayırma, durağanlık, ACF/PACF, ADF testi ve ARIMA: sırası olan veriyi okumanın ve tahmin etmenin temelleri, R örnekleriyle.
Hipotez, kontrol ve test grupları, dönüşüm oranı, lift ve istatistiksel anlamlılık: bir A/B testi baştan sona nasıl kurulur ve yorumlanır?
Tokenization, stop words, stemming, lemmatization, TF-IDF ve metin sınıflandırma: metni veriye, veriyi içgörüye dönüştürmenin yolları.
Fact ve dimension tabloları, 1:* ilişkiler, filtre yönü ve DAX ölçüleri: Power BI'da sağlam bir veri modeli nasıl kurulur?
TP, TN, FP ve FN'den accuracy, precision, recall ve F1-score'a: hangi metriğe ne zaman bakılır, dengesiz veride accuracy neden yanıltır?
Series ve DataFrame, veri okuma, filtreleme, sıralama, groupby ile özetleme ve merge ile birleştirme — Pandas'ın günlük analiz akışı.
Mention, sentiment, etkileşim, konu ve kanal verilerini birlikte okuyarak markanın dijital itibarını nasıl analiz ederiz?
Kümeleme mantığı, K değerinin seçimi, elbow method, silhouette score ve Python ile müşteri segmentasyonu örneği.
Power BI'da measure ve calculated column farkı, CALCULATE, FILTER, SUMX, DISTINCTCOUNT ve zaman bazlı DAX hesaplamaları.
SELECT, WHERE, GROUP BY, HAVING, JOIN, CASE WHEN ve window functions yapılarını gerçek hayattan veri analizi örnekleriyle anlatıyorum.
EDA nedir? Python ve pandas ile bir veri setini tanıma: eksik değerler, aykırı değerler, dağılımlar ve değişkenler arası ilişkiler.
Veri analistleri hangi araçları kullanır, gün içinde neler yapar? Kendi deneyimlerimden yola çıkarak bir günümü anlatıyorum.
Tekrarlayan rapor süreçlerini otomatikleştirerek zaman kazanın. Bu yazıda adım adım bir örnek üzerinden nasıl ilerlediğimi anlatıyorum.
Tekrarlayan Excel işlemlerini makrolarla otomatikleştirerek zaman kazanmanın yollarını, temel VBA mantığını ve pratik raporlama örneklerini anlatıyorum.
Sosyal medya dinleme, markalar için neden kritik? Hangi araçlar kullanılır ve süreç nasıl yönetilir? Baştan sona ele alıyorum.
Gerçek hayattan örneklerle, dağınık verileri temizlemek için kullandığım pratik yöntemleri açıklıyorum.
Etkili bir dashboard, sadece veri göstermekle kalmaz; aynı zamanda doğru karar almayı kolaylaştırmalıdır. Bu yazıda dikkat edilmesi gereken temel noktaları paylaşıyorum.
Etkili bir Tableau dashboard sadece veri göstermekle kalmaz; doğru görsel hiyerarşi, etkileşim ve sade tasarımla kullanıcıyı doğru karara götürür.
Sosyal medyada markalar hakkında konuşulanları anlamak, sadece negatif yorumları görmekten çok daha fazlasıdır.
Python ile etkileyici görselleştirmeler oluşturmak için ggplot yaklaşımını ve plotnine kütüphanesinin temel kullanımını ele alıyorum.
R ile etkileyici görselleştirmeler oluşturmak için ggplot2 paketinin temel kullanımını ele alıyorum.
Yapay zeka, veri analitiğinin işini nasıl dönüştürüyor? Sektör için fırsatları ve dikkat edilmesi gereken riskleri birlikte inceleyelim.
Python'da bulunan temel paketleri ile ilgili veri görselleştirme yöntemleri
GGPlo2 ve Plotly paketleri ile ilgili veri görselleştirme yöntemleri
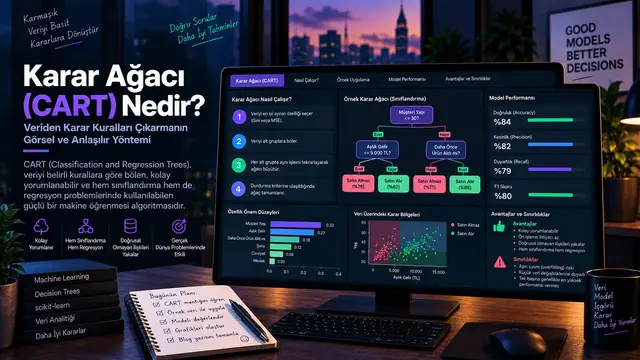
Karar Ağaçları, hem sınıflandırma hem de regresyon problemleri için kullanılan, ağaç benzeri bir yapıya sahip makine öğrenimi algoritmalarıdır. Verileri özelliklerine göre dallara ayırarak bir dizi karar kuralı oluşturur ve bu kurallar sayesinde hedef değişkenin değerini tahmin eder. Yorumlanabilirliği yüksek ve uygulaması nispeten kolay bir modeldir.
Seyahat planlamasında verinin nasıl kullanılabileceğini; bütçe, rota, yorum analizi ve kişiselleştirilmiş öneriler üzerinden keşfedelim.
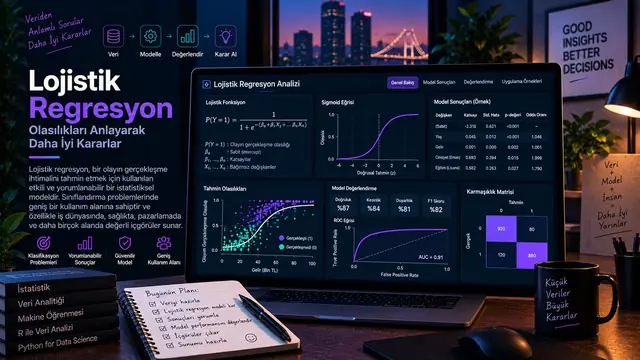
Lojistik regresyon, bağımlı değişkenin iki kategorili (örneğin: evet/hayır, hasta/sağlıklı) olduğu durumlarda kullanılan bir istatistiksel modeldir. Bu yöntem, olasılıkları tahmin ederek verinin belirli bir sınıfa ait olup olmadığını belirlemeye yarar. Lineer regresyondan farklı olarak, sonuçları 0 ile 1 arasında bir olasılık değeri olarak verir.
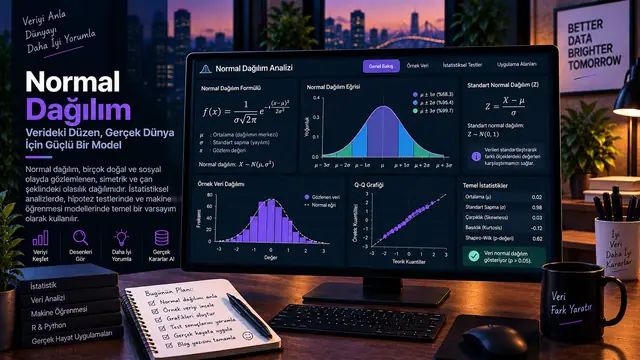
Normal dağılım, ortalaması etrafında simetrik şekilde yayılan ve çan eğrisi (Gauss dağılımı) olarak bilinen sürekli bir olasılık dağılımıdır. Ortalama, medyan ve modun eşit olması temel özelliklerinden biridir. İstatistikte birçok test ve model, verilerin normal dağılıma sahip olduğu varsayımına dayanır.
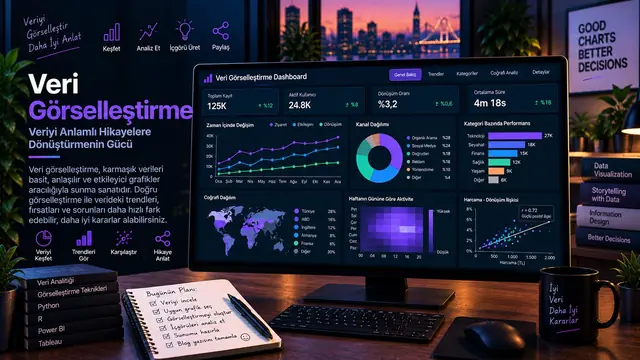
Veri görselleştirme, sayısal ve karmaşık verilerin grafikler, tablolar ve görsel öğeler aracılığıyla daha anlaşılır hale getirilmesini sağlayan bir tekniktir.
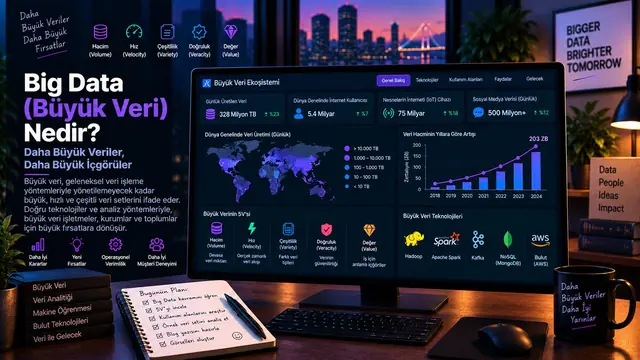
Büyük Veri, hacim, hız ve çeşitlilik açısından geleneksel veri işleme yöntemleriyle yönetilmesi zor olan çok büyük ve karmaşık veri kümelerini ifade eder. Bu verilerden anlamlı bilgi üretmek için gelişmiş analitik, makine öğrenmesi ve dağıtık sistemler kullanılır.
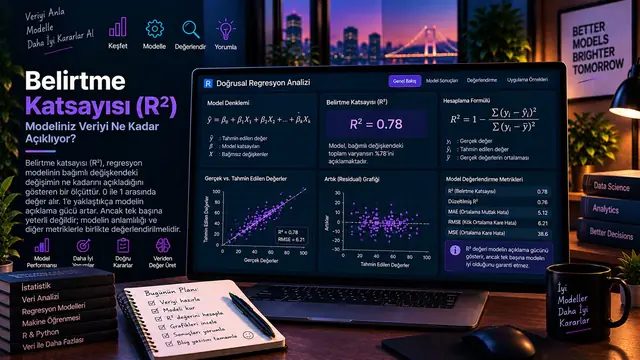
Belirleme katsayısı (R²), bir regresyon modelinde bağımsız değişkenlerin, bağımlı değişkendeki toplam değişimin ne kadarını açıkladığını gösteren ölçüdür.
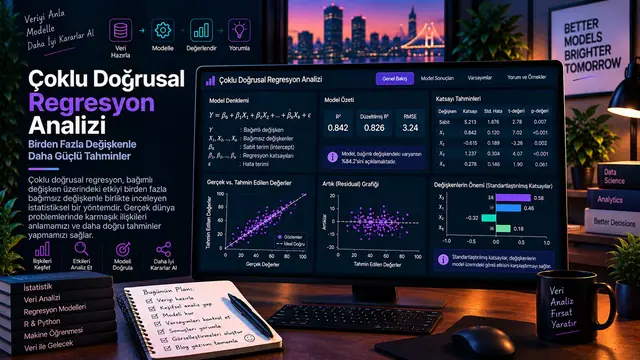
Çoklu doğrusal regresyon, bir bağımlı değişken ile iki ya da daha fazla bağımsız değişken arasındaki doğrusal ilişkiyi modellemek için kullanılan istatistiksel bir yöntemdir.
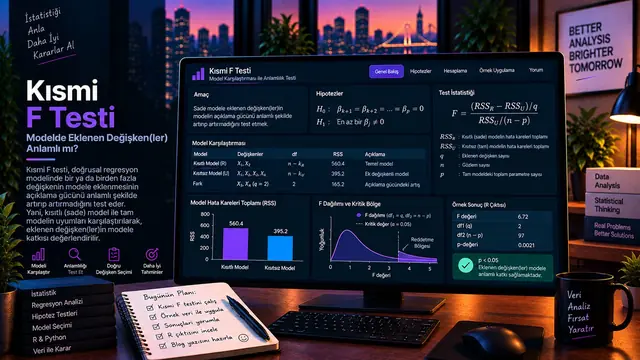
Kısmi F testi, iç içe iki regresyon modelini karşılaştırarak modele eklenen değişkenlerin anlamlı katkı sağlayıp sağlamadığını gösterir.
Aramanıza uygun yazı bulunamadı.