Zaman Serisi Analizi: Trend, Mevsimsellik ve Tahminleme
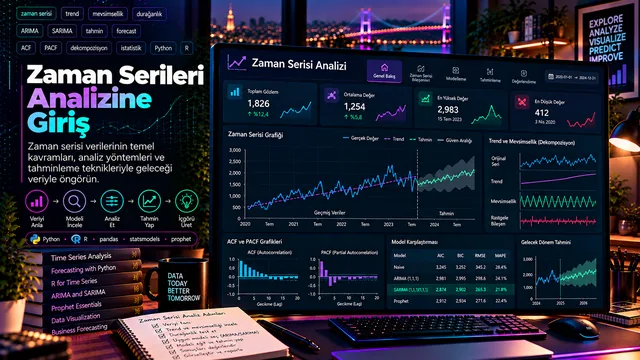
Hangi tahmin yöntemi işinize yarar ve bunu nasıl ölçersiniz? Trend ve mevsimselliği ayrıştırmadan baseline kurmaya, zamansal doğrulamadan hata metriklerine kadar tahminleme sürecini Python örnekleriyle anlatıyorum.
- İstatistik
- Makine Öğrenmesi
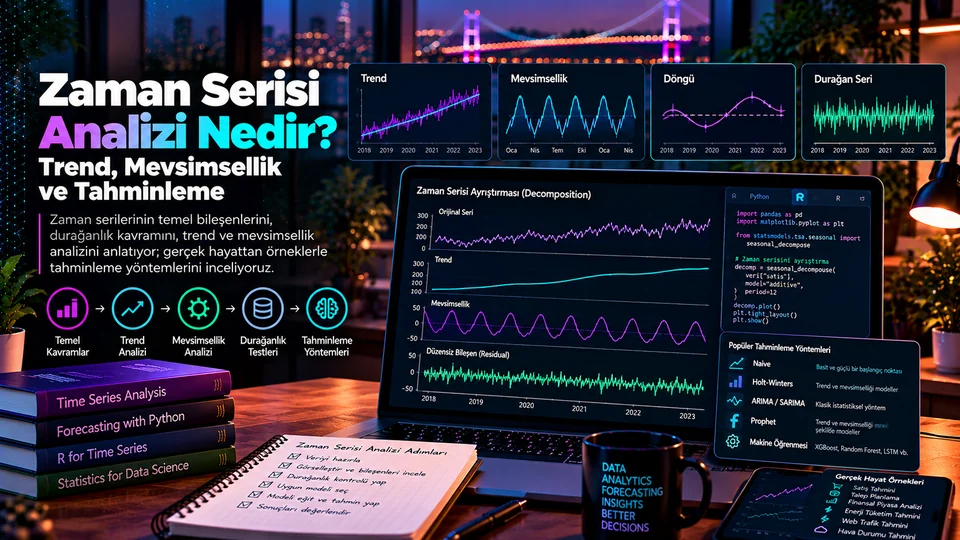
Zaman serisi analizi nedir?
Zaman serisi, belirli zaman noktalarında veya aralıklarında sıralı biçimde gözlemlenen değerlerden oluşur. Zaman serisi analizi; bu gözlemlerdeki yapıyı, bağımlılıkları ve değişimi inceleyerek açıklama, izleme veya tahmin üretme sürecidir.
Günlük satışlar, saatlik elektrik tüketimi, aylık enflasyon, web sitesi ziyaretleri, çağrı merkezi talepleri ve sosyal medya mention hacmi zaman serilerine örnektir. Bu verilerde gözlemlerin sırası önemlidir: bugünkü satışlar, çoğu zaman dünkü satışlardan ve haftanın gününden bağımsız değildir.
Açıklama
Hangi örüntüler gözlenen değişimi açıklıyor? Trend mi, mevsimsellik mi, kampanya etkisi mi?
Tahmin
Geçmiş örüntüler ve bilinen etkenler ışığında gelecek dönemlerde ne beklenebilir?
auto.arima() ile model seçimi — ayrı bir yazıda R üzerinden işleniyor: Zaman Serisi Analizine Giriş. Burada ise yöntem seçimi, baseline kurma ve tahmin doğruluğunu ölçme üzerinde duruyorum.Zaman serisinin temel bileşenleri
Bir zaman serisini anlamak için gözlenen değerin hangi örüntülerden oluşabileceğini düşünmek gerekir. Klasik ayrıştırmada trend, mevsimsellik ve düzensiz bileşenler ele alınır; bazı durumlarda döngüsel hareketler de ayrı değerlendirilir.
| Bileşen | Açıklama | Örnek |
|---|---|---|
| Trend | Uzun vadeli genel yönelim. | Yıllar içinde artan müşteri sayısı. |
| Mevsimsellik | Sabit ve bilinen takvim aralıklarında tekrar eden örüntü. | Her aralık ayında artan perakende satışları. |
| Döngü | Sabit uzunluğu olmayan, daha uzun dönemli genişleme ve daralma hareketleri. | Ekonomik konjonktürle ilişkili talep değişimi. |
| Düzensiz bileşen | Diğer bileşenlerle açıklanamayan kısa vadeli değişim. | Beklenmedik bir kesinti sonrası talep dalgalanması. |
Toplamsal ve çarpımsal yapı
Toplamsal modelde bileşenler bir araya gelerek gözlemi oluşturur. Çarpımsal modelde ise mevsimsel dalgalanmanın büyüklüğü serinin seviyesiyle birlikte artar.
# Toplamsal ayrıştırma
Y[t] = Trend[t] + Seasonal[t] + Remainder[t]

# Çarpımsal ayrıştırma
Y[t] = Trend[t] * Seasonal[t] * Remainder[t]
Satışlar yükseldikçe yaz aylarındaki ek satışlar da mutlak olarak büyüyorsa çarpımsal yapı ya da logaritmik dönüşüm anlamlıdır. Seride sıfır veya negatif değerler varsa çarpımsal yaklaşım doğrudan uygulanamaz — logaritma tanımsız kalır.
Trend analizi nasıl yapılır?
Trend, serinin uzun vadeli yönelimini gösterir. Ancak her yükseliş kalıcı büyüme anlamına gelmez; takvim etkileri, kampanyalar, ölçüm değişiklikleri ve uç değerler trend izlenimini kolayca değiştirir.
Hareketli ortalama
Hareketli ortalama, kısa vadeli dalgalanmaları yumuşatarak daha genel eğilimi görmeyi sağlar. Günlük satışlarda 7 günlük hareketli ortalama, haftanın günlerinden kaynaklanan dalgalanmayı büyük ölçüde temizler.
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("gunluk_satis.csv", parse_dates=["tarih"])
df = df.sort_values("tarih").set_index("tarih")

df["ortalama_7g"] = df["satis"].rolling(7, min_periods=7).mean()

df[["satis", "ortalama_7g"]].plot()
plt.title("Günlük satışlar ve 7 günlük hareketli ortalama")
plt.tight_layout()
plt.show()
Hareketli ortalama bir tahmin modeli değildir; görselleştirme ve yumuşatma aracıdır. Pencere büyüdükçe seri daha fazla yumuşar ama ani değişimlere daha geç tepki verir. min_periods=7 yazmak, ilk altı günde yarım pencereyle hesaplanmış yanıltıcı değerler üretilmesini engeller.
Doğrusal trend
Basit doğrusal regresyon, zaman ile değer arasında yaklaşık doğrusal bir ilişki varsa kullanılabilir. Gerçek serilerde trend doğrusal olmak zorunda değildir; kırılmalar veya doygunluk sık görülür.
import numpy as np
from sklearn.linear_model import LinearRegression

y = df["satis"].dropna()
t = np.arange(len(y)).reshape(-1, 1)

model = LinearRegression().fit(t, y)
trend = model.predict(t)
Bu örnek gözlemlerin eşit aralıklarla geldiğini varsayar. Takvimde boşluklar varsa np.arange ile üretilen sıra numarası gerçek zamanı temsil etmez; bu durumda gerçek zaman indeksini modellemek veya eksik dönemleri açıkça ele almak gerekir.
Mevsimsellik nasıl analiz edilir?
Mevsimsellik, belirli bir takvim döngüsü boyunca tekrarlayan örüntüdür. Günlük veride haftalık, aylık veride yıllık mevsimsellik görülür. Döngüden farkı, mevsimselliğin bilinen ve sabit bir periyoda sahip olmasıdır.
Örnekler: restoranlarda hafta sonu yoğunluğu, ısıtma tüketiminde kış artışı, turizmde yaz sezonu, perakendede yıl sonu kampanyaları. Mevsimsel etkiyi incelerken resmî tatiller, hareketli bayram tarihleri ve kampanyalar gibi takvim etkilerini ayrıca düşünmek gerekir — Türkiye verisinde bayramların her yıl kayması, sabit periyot varsayımını tek başına yetersiz bırakır.
STL ile ayrıştırma
STL (Seasonal-Trend decomposition using Loess), seriyi trend, mevsimsellik ve kalan bileşenlere ayıran esnek bir yöntemdir. Mevsimsel desen zamanla değişebiliyorsa klasik ayrıştırmadan daha uygundur.
from statsmodels.tsa.seasonal import STL

# Gunluk seride haftalik mevsimsellik: period=7
sonuc = STL(df["satis"].asfreq("D").interpolate(),
            period=7, robust=True).fit()

sonuc.plot()
plt.tight_layout()
plt.show()
Örnekte period=7 günlük seride haftalık mevsimsellik varsayar; aylık veride yıllık döngü için period=12 kullanılır. robust=True, uç değerlerin mevsimsel bileşeni bozmasını sınırlar. Koddaki interpolate() yalnızca gösterim amaçlıdır: üretim analizinde eksik zaman noktalarının nedeni ve uygun doldurma yöntemi ayrıca değerlendirilmelidir.
Durağanlık nedir, neden önemlidir?
Bir zaman serisi, kabaca zaman içinde değişmeyen istatistiksel özelliklere sahipse durağan kabul edilir. Zayıf durağanlık bağlamında ortalamanın ve varyansın sabit olması, kovaryansın ise yalnızca iki gözlem arasındaki gecikmeye bağlı olması beklenir.
Belirgin trend veya değişen mevsimsel seviye içeren seriler durağan değildir. Durağanlık özellikle ARMA ailesi için önemlidir; ancak her tahmin yöntemi aynı biçimde durağan girdi istemez. Üstel düzeltme ve ağaç tabanlı modeller bu varsayımı doğrudan gerektirmez.
Durağanlığı değerlendirme
- Zaman grafiğinde seviyenin ve varyansın zamanla değişip değişmediğine bakın.
- ACF grafiğiyle gecikmeler arasındaki korelasyonun davranışını inceleyin.
- ADF gibi testleri yardımcı kanıt olarak kullanın; tek başına p-değeriyle karar vermeyin.
from statsmodels.tsa.stattools import adfuller

seri = df["satis"].dropna()
adf_sonuc = adfuller(seri, autolag="AIC")

print("ADF istatistiği:", adf_sonuc[0])
print("p-değeri:", adf_sonuc[1])
ADF testinin sıfır hipotezi birim kök bulunduğudur. Küçük p-değeri, testin varsayımları altında bu hipoteze karşı kanıt sunar — yani serinin durağan olmadığı iddiasını zayıflatır. Test; kırılmalar, mevsimsellik ve örneklem uzunluğundan etkilenir, bu yüzden grafik ve alan bilgisiyle birlikte yorumlanmalıdır.
Fark alma
df["satis_fark"] = df["satis"].diff()Fark alma, ardışık gözlemler arasındaki değişimi modelleyerek bazı trend yapılarını giderir. Mevsimsel fark alma ise belirli periyotla ayrılmış gözlemleri karşılaştırır; aylık seride diff(12) gibi. Gereğinden fazla fark almak yorumlanabilirliği azaltır ve modelin davranışını bozar.
Başlıca tahminleme yöntemleri
| Yöntem | Ne zaman işe yarar? | Dikkat |
|---|---|---|
| Naif tahmin | Son gözlemi bir sonraki dönem için tahmin olarak kullanır. | Güçlü bir kıyaslama noktasıdır; trendi yakalamaz. |
| Mevsimsel naif | Bir önceki mevsimsel dönemin değerini kullanır. | Mevsimsel örüntü istikrarlıysa yenilmesi zor bir baseline. |
| Üstel düzeltme | Seviye, trend ve mevsimsellik bileşenlerini yumuşatır. | Serinin yapısına uygun varyant seçilmelidir. |
| ARIMA / SARIMA | Gecikmeli bağımlılıkları ve gerekirse mevsimsel yapıyı modeller. | Tanılama, parametre seçimi ve artık kontrolleri şart. |
| Regresyon + takvim | Tatil, fiyat, kampanya veya hava durumu biliniyorsa. | Gelecek dönem için açıklayıcı değişken değerleri gerekir. |
| Makine öğrenmesi | Çok sayıda özellik ve doğrusal olmayan ilişki varsa. | Zamansal doğrulama ve veri sızıntısını önleme zorunlu. |
Önce basit bir kıyaslama modeli kurun
Karmaşık bir modelin işe yarayıp yaramadığını anlamanın tek yolu, onu naif veya mevsimsel naif bir tahminle karşılaştırmaktır. Baseline'ı geçemeyen bir modelin karmaşıklığı gerekçelendirilemez — ve bu durum sanıldığından çok daha sık görülür.
import numpy as np

# Gunluk seride haftalik sezonsallik varsayimiyla
mevsim = 7
train = df["satis"].iloc[:-28]
test  = df["satis"].iloc[-28:]

tahmin = train.iloc[-mevsim:].to_numpy()
tahmin = np.resize(tahmin, len(test))
Bu kod, eğitim setinin son haftasındaki değerleri test dönemi boyunca sırayla tekrarlar. Basit görünse de mevsimselliği güçlü serilerde şaşırtıcı derecede iyi çalışır. İleri değerlendirmede tahmin ufkuna, eksik günlere ve hafta içi/hafta sonu yapısına dikkat edin.
Tahmin doğruluğu nasıl ölçülür?
Modeli rastgele train-test ayırımıyla değerlendirmek zaman serilerinde yanlıştır: gelecekteki gözlemler eğitim sürecine sızar ve model olduğundan iyi görünür. Bunun yerine kronolojik ayırım ya da kayan başlangıçlı zaman serisi çapraz doğrulaması kullanılır.
| Metrik | Yorum | Sınırlılık |
|---|---|---|
| MAE | Mutlak hataların ortalaması; hedefin kendi biriminde yorumlanır. | Büyük hataları ayrıca cezalandırmaz. |
| RMSE | Büyük hatalara daha fazla ağırlık verir. | Uç değerlere duyarlıdır. |
| MAPE | Hata oranını yüzde olarak sunar; birimden bağımsızdır. | Gerçek değer sıfıra yakınsa patlar, sıfırsa tanımsızdır. |
import numpy as np
from sklearn.metrics import mean_absolute_error, mean_squared_error

mae  = mean_absolute_error(test, tahmin)
rmse = np.sqrt(mean_squared_error(test, tahmin))

print(f"MAE: {mae:.2f}")
print(f"RMSE: {rmse:.2f}")
Model seçerken tek bir test dönemi yeterli değildir. Farklı başlangıç tarihlerinde aynı tahmin ufkunu değerlendirmek, modelin dönemler arasında ne kadar tutarlı olduğunu gösterir. Tahmin aralıkları da en az nokta tahmini kadar önemlidir: karar vericiye belirsizliğin büyüklüğünü aktaran şey odur.
Gerçek hayattan dört senaryo
Perakende satış
Günlük satışlarda trend, haftalık mevsimsellik, tatiller ve promosyonlar birlikte değerlendirilir. Tahminler stok ve personel planlamasını besler.
Enerji tüketimi
Saatlik tüketim; sıcaklık, gün saati, hafta sonu ve mevsimlerden etkilenir. Dışsal değişkenler tahmini belirgin biçimde iyileştirir.
Marka ve sosyal medya
Günlük mention hacmi kampanyalar, gündem olayları ve haber akışından etkilenir. Ani sıçramaları trend sanmamak gerekir.
Çağrı merkezi
Saatlik çağrı sayısı vardiya planlaması için tahmin edilir. Takvim, kampanya ve beklenmedik kesintiler ayrı ele alınır.
Sosyal medya analizinde belirli bir gün mention sayısının yükselmesi kalıcı büyüme değildir. Bu artış viral bir paylaşım, haber olayı veya kampanya kaynaklı olabilir. Model yalnızca geçmiş sayılara değil, mümkün olduğunda olay takvimine ve açıklayıcı değişkenlere de bakmalıdır.
Uçtan uca zaman serisi iş akışı
- Zaman İndeksini
Doğrula - Görselleştir
- Bileşenleri
İncele - Baseline
Kur - Modeli
Eğit - Zamansal
Doğrula
- Frekans: günlük, haftalık veya aylık gözlemlerin düzenli olup olmadığını kontrol edin.
- Eksik zaman noktaları: olmayan kayıt sıfır mı, yoksa veri toplanmamış mı? Bu ayrım tahmini doğrudan değiştirir.
- Aykırı değerler: hatalı veri mi, yoksa gerçekten yaşanmış bir olay mı — araştırmadan silmeyin.
- Takvim etkileri: tatil, hafta sonu ve kampanya gibi bilinen etkileri önceden belirleyin.
- Doğrulama: geçmişten geleceğe doğru ayırın ve gerçek kullanımdaki tahmin ufkuyla aynı ufukta ölçün.
- İzleme: gerçekleşen değerlerle tahminleri karşılaştırıp hatayı ve veri yapısındaki kaymayı sürekli izleyin.
Kaçınılması gereken hatalar
- Gözlemleri zaman sırasına koymadan model kurmak.
- Eksik tarihleri otomatik sıfırla doldurmak; sıfır ile gözlenmemiş değeri karıştırmak.
- Geleceğe ait bilgiyi eğitim verisine sokmak (veri sızıntısı).
- Modeli yalnızca eğitim verisindeki uyuma göre seçmek.
- Mevsimselliği göz ardı edip yalnızca doğrusal trend eklemek.
- Tahmin belirsizliğini ve olası yapısal kırılmaları raporlamamak.
- Geçmişteki iyi performansın gelecekte de süreceğini varsaymak.
Zaman serisi analizi, örüntüleri anlamakla başlar
Başarılı bir zaman serisi çalışması karmaşık bir algoritma seçmekle başlamaz. Önce verinin frekansı, eksik zaman noktaları, trendi ve mevsimselliği anlaşılır; ardından durağanlık ve bağımlılık yapısı değerlendirilir. Basit tahmin yöntemleri güçlü bir başlangıç noktasıdır; daha karmaşık modeller ancak ölçülebilir fayda sağladıklarında tercih edilmelidir.
Satış, enerji, finans, operasyon veya sosyal medya verisi üzerinde çalışın — doğru zaman indeksini kurmak, kronolojik doğrulama yapmak ve hataları düzenli izlemek tahmin kalitesini artıran temel adımlardır.
auto.arima() bölümleri doğal devam noktası.What is time series analysis?
A time series consists of values observed in order at specific points or intervals in time. Time series analysis is the process of examining the structure, dependencies and change in those observations in order to explain, monitor or forecast.
Daily sales, hourly electricity consumption, monthly inflation, website visits, call centre demand and social media mention volume are all time series. The order of the observations matters here: today's sales are rarely independent of yesterday's, or of the day of the week.
Explanation
Which patterns explain the observed variation? Trend, seasonality, or a campaign effect?
Forecasting
Given past patterns and known drivers, what can be expected in the periods ahead?
auto.arima() — is covered separately in R: Introduction to Time Series Analysis. Here I concentrate on choosing a method, building a baseline and measuring forecast accuracy.The components of a time series
To understand a series, it helps to think about which patterns the observed value may be made of. Classical decomposition considers trend, seasonality and an irregular component; in some cases cyclical movements are treated separately.
| Component | Description | Example |
|---|---|---|
| Trend | The long-term general direction. | Customer numbers rising over the years. |
| Seasonality | A pattern repeating over fixed, known calendar intervals. | Retail sales rising every December. |
| Cycle | Longer expansions and contractions with no fixed length. | Demand shifts tied to the economic cycle. |
| Irregular | Short-term variation the other components do not explain. | A demand swing after an unexpected outage. |
Additive and multiplicative structure
In an additive model the components sum to the observation. In a multiplicative model the size of the seasonal swing grows with the level of the series.
# Additive decomposition
Y[t] = Trend[t] + Seasonal[t] + Remainder[t]

# Multiplicative decomposition
Y[t] = Trend[t] * Seasonal[t] * Remainder[t]
If the extra summer sales grow in absolute terms as sales rise overall, a multiplicative structure or a log transform makes sense. If the series contains zeros or negative values, the multiplicative approach cannot be applied directly — the logarithm is undefined.
How do you analyse trend?
Trend shows the long-term direction of the series. But not every rise means lasting growth; calendar effects, campaigns, measurement changes and outliers easily distort the impression of a trend.
Moving average
A moving average smooths short-term fluctuation so the broader tendency becomes visible. On daily sales, a 7-day moving average largely removes day-of-week variation.
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("gunluk_satis.csv", parse_dates=["tarih"])
df = df.sort_values("tarih").set_index("tarih")

df["ortalama_7g"] = df["satis"].rolling(7, min_periods=7).mean()

df[["satis", "ortalama_7g"]].plot()
plt.title("Daily sales and 7-day moving average")
plt.tight_layout()
plt.show()
A moving average is not a forecasting model; it is a visualisation and smoothing tool. The wider the window, the smoother the series — and the slower it reacts to sudden change. Writing min_periods=7 prevents misleading values computed from a half-filled window over the first six days.
Linear trend
Simple linear regression works when the relationship between time and value is roughly linear. In real series the trend need not be linear; breaks and saturation are common.
import numpy as np
from sklearn.linear_model import LinearRegression

y = df["satis"].dropna()
t = np.arange(len(y)).reshape(-1, 1)

model = LinearRegression().fit(t, y)
trend = model.predict(t)
This example assumes observations arrive at equal intervals. If the calendar has gaps, the index produced by np.arange no longer represents real time; you then need to model the actual time index or handle the missing periods explicitly.
How do you analyse seasonality?
Seasonality is a pattern that repeats over a particular calendar cycle. Daily data shows weekly seasonality, monthly data yearly seasonality. What separates it from a cycle is that seasonality has a known, fixed period.
Examples: weekend peaks in restaurants, winter rises in heating consumption, the summer season in tourism, year-end campaigns in retail. When examining seasonal effects, calendar effects such as public holidays, moving religious holidays and campaigns need separate thought — in Turkish data, holidays shifting every year make the fixed-period assumption insufficient on its own.
Decomposition with STL
STL (Seasonal-Trend decomposition using Loess) is a flexible method for splitting a series into trend, seasonal and remainder components. It suits cases where the seasonal pattern changes over time better than classical decomposition.
from statsmodels.tsa.seasonal import STL

# Weekly seasonality on a daily series: period=7
sonuc = STL(df["satis"].asfreq("D").interpolate(),
            period=7, robust=True).fit()

sonuc.plot()
plt.tight_layout()
plt.show()
Here period=7 assumes weekly seasonality on a daily series; for a yearly cycle in monthly data you would use period=12. robust=True limits how much outliers distort the seasonal component. The interpolate() call is for demonstration only: in production the reason for missing time points and the appropriate filling method need separate consideration.
What is stationarity and why does it matter?
A time series is considered stationary if its statistical properties are roughly unchanging over time. Under weak stationarity, the mean and variance are expected to be constant and the covariance to depend only on the lag between two observations.
Series with a clear trend or a shifting seasonal level are not stationary. Stationarity matters particularly for the ARMA family; not every forecasting method demands a stationary input in the same way. Exponential smoothing and tree-based models do not require the assumption directly.
Assessing stationarity
- Look at the time plot to see whether the level and variance change over time.
- Examine the behaviour of correlation across lags with an ACF plot.
- Use tests such as ADF as supporting evidence; do not decide on a p-value alone.
from statsmodels.tsa.stattools import adfuller

seri = df["satis"].dropna()
adf_sonuc = adfuller(seri, autolag="AIC")

print("ADF statistic:", adf_sonuc[0])
print("p-value:", adf_sonuc[1])
The null hypothesis of the ADF test is that a unit root is present. A small p-value provides evidence against that null under the test's assumptions — that is, it weakens the claim that the series is not stationary. The test is affected by breaks, seasonality and sample length, so read it together with the plot and domain knowledge.
Differencing
df["satis_fark"] = df["satis"].diff()Differencing models the change between consecutive observations and removes some trend structures. Seasonal differencing compares observations a fixed period apart — diff(12) on a monthly series, for example. Differencing more than necessary reduces interpretability and distorts the model's behaviour.
The main forecasting methods
| Method | When it helps | Watch out for |
|---|---|---|
| Naive forecast | Uses the last observation as the forecast for the next period. | A strong benchmark; does not capture trend. |
| Seasonal naive | Uses the value from the previous seasonal period. | Hard to beat when the seasonal pattern is stable. |
| Exponential smoothing | Smooths level, trend and seasonal components. | The variant must match the structure of the series. |
| ARIMA / SARIMA | Models lagged dependencies and, if needed, seasonal structure. | Diagnostics, parameter choice and residual checks are essential. |
| Regression + calendar | When holidays, price, campaigns or weather are known. | You need values of the explanatory variables for the future period. |
| Machine learning | With many features and non-linear relationships. | Temporal validation and preventing leakage are mandatory. |
Build a simple benchmark first
The only way to know whether a complex model is worth it is to compare it against a naive or seasonal naive forecast. A model that cannot beat the baseline cannot justify its complexity — and this happens far more often than people expect.
import numpy as np

# Assuming weekly seasonality on a daily series
mevsim = 7
train = df["satis"].iloc[:-28]
test  = df["satis"].iloc[-28:]

tahmin = train.iloc[-mevsim:].to_numpy()
tahmin = np.resize(tahmin, len(test))
This repeats the values of the final training week across the test period. Simple as it looks, it performs surprisingly well on strongly seasonal series. For a fuller evaluation, pay attention to the forecast horizon, missing days and the weekday/weekend structure.
How do you measure forecast accuracy?
Evaluating a model with a random train-test split is wrong for time series: future observations leak into training and the model looks better than it is. Use a chronological split, or rolling-origin time series cross-validation instead.
| Metric | Interpretation | Limitation |
|---|---|---|
| MAE | Mean of absolute errors; read in the target's own unit. | Does not penalise large errors any further. |
| RMSE | Gives more weight to large errors. | Sensitive to outliers. |
| MAPE | Expresses error as a percentage; unit-independent. | Explodes near zero and is undefined at zero. |
import numpy as np
from sklearn.metrics import mean_absolute_error, mean_squared_error

mae  = mean_absolute_error(test, tahmin)
rmse = np.sqrt(mean_squared_error(test, tahmin))

print(f"MAE: {mae:.2f}")
print(f"RMSE: {rmse:.2f}")
One test period is not enough when choosing a model. Evaluating the same horizon from several different start dates shows how consistent the model is across periods. Prediction intervals matter at least as much as the point forecast: they are what communicates the size of the uncertainty to a decision-maker.
Four real-world scenarios
Retail sales
Trend, weekly seasonality, holidays and promotions are weighed together in daily sales. Forecasts feed stock and staff planning.
Energy consumption
Hourly consumption is driven by temperature, hour of day, weekends and seasons. External variables improve forecasts markedly.
Brand and social media
Daily mention volume is shaped by campaigns, news events and the agenda. A sudden spike should not be mistaken for a trend.
Call centre
Hourly call volume is forecast for shift planning. Calendar, campaigns and unexpected outages are handled separately.
In social media analysis, a rise in mentions on a particular day is not lasting growth. It may come from a viral post, a news event or a campaign. The model should look not only at past counts but, where possible, at an events calendar and explanatory variables.
An end-to-end time series workflow
- Validate the
Time Index - Visualise
- Inspect
Components - Build a
Baseline - Train the
Model - Validate
Temporally
- Frequency: check whether daily, weekly or monthly observations are regular.
- Missing time points: is an absent record a zero, or was no data collected? The distinction changes the forecast directly.
- Outliers: bad data or a real event — do not delete before investigating.
- Calendar effects: identify known effects such as holidays, weekends and campaigns in advance.
- Validation: split from past to future, and measure over the same horizon you will actually forecast.
- Monitoring: compare realised values against forecasts and keep watching the error and any drift in the data.
Mistakes to avoid
- Fitting a model without putting the observations in time order.
- Filling missing dates with zero automatically, conflating zero with unobserved.
- Letting information about the future into the training data (leakage).
- Choosing a model purely on its fit to the training data.
- Ignoring seasonality and adding only a linear trend.
- Failing to report forecast uncertainty and possible structural breaks.
- Assuming that past performance guarantees future performance.
Time series analysis starts with understanding patterns
A successful time series project does not start by picking a complex algorithm. First you understand the frequency of the data, the missing time points, the trend and the seasonality; then you assess stationarity and the dependency structure. Simple forecasting methods are a strong starting point; more complex models should only be preferred when they deliver measurable benefit.
Whether you work on sales, energy, finance, operations or social media data, building the right time index, validating chronologically and monitoring errors regularly are the fundamental steps that improve forecast quality.
auto.arima() sections of the introductory post are the natural next step.