Sosyal Medya Verileriyle Marka Karşılaştırması
“Hangi marka daha iyi?” ölçülebilir bir soru değil. Hacim, etkileşim oranı, duygu dağılımı ve konuşulma payını aynı kapsamda nasıl ölçeceğinizi ve her birinin neyi söyleyip neyi söylemediğini anlatıyorum.
- Sosyal Medya
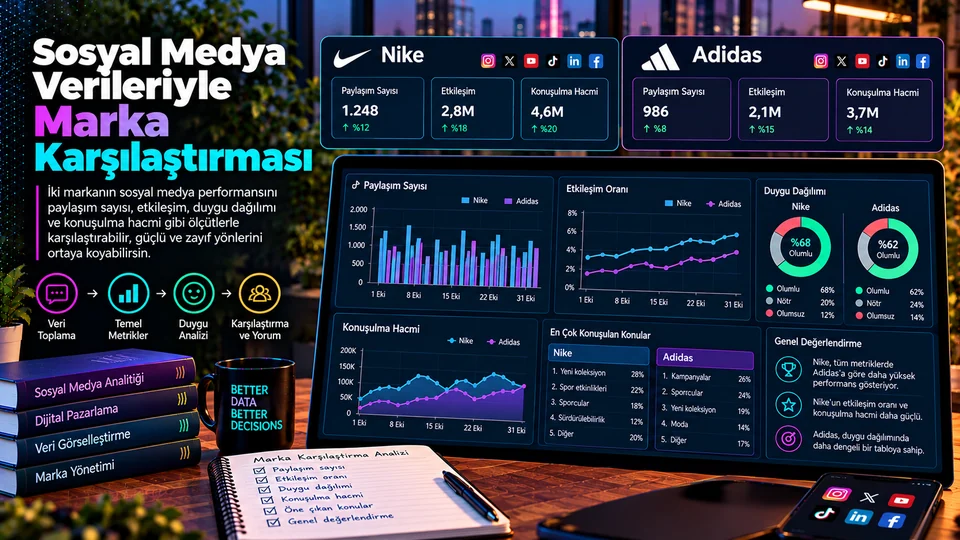
Karşılaştırma neyi yanıtlamalı?
“Hangi marka daha iyi?” tek başına ölçülebilir bir soru değildir. Daha çok mu konuşuluyor, daha yüksek etkileşim mi alıyor, yoksa konuşmalarındaki ton mu daha olumlu? Bu üç soru farklı metrikler, farklı paydalar ve farklı yorumlar gerektirir.
Karşılaştırma için aynı tarih aralığını, benzer platform kapsamını ve tutarlı marka sorgularını kullanın. Marka isminin yaygın bir kelimeyle çakışması, aynı adı taşıyan başka ürünler veya kullanıcı adları sonucu kirletir; sorgularınızı mutlaka örnek paylaşımlar üzerinden doğrulayın.
1. Veriyi hazırlayın
Her paylaşım için marka, platform, zaman, metin, etkileşim sayıları ve mümkünse erişim/gösterim alanları tutarlı biçimde saklanmalı. Tekilleştirme, dil tespiti, spam filtresi ve yeniden paylaşımların nasıl ele alınacağı gibi kuralları en baştan belirleyin.
import pandas as pd

df = pd.read_csv("veri/sosyal_paylasimlar.csv", parse_dates=["tarih"])

df["marka"] = df["marka"].str.strip().str.casefold()
df["etkilesim"] = df[["begeni", "yorum", "paylasim"]].fillna(0).sum(axis=1)
df["gun"] = df["tarih"].dt.date

print(df.groupby("marka").size())
print(df[["platform", "tarih", "marka"]].isna().sum())casefold(), lower()'dan biraz daha agresif bir normalleştirme yapar (örneğin Almanca ß'yi ss'ye çevirir) ve karşılaştırma amaçlı eşleştirmede tercih edilir. Ama dikkat: ikisi de yerel ayara duyarlı değildir. Python'da "I".casefold() sonucu "i"dir, Türkçedeki "ı" değil. Marka adlarında Türkçe büyük/küçük harf farkı önemliyse bunu ayrıca ele almanız gerekir. Beğeni, yorum ve paylaşımı tek bir etkileşim puanında toplarken de ağırlıklarının eşit olduğunu varsaydığınızı unutmayın; farklı ağırlık kullanıyorsanız formülü raporda açıkça yazın.
2. Paylaşım sayısı ve konuşulma hacmi
Markanın kendi paylaşım sayısı, ne kadar içerik yayımladığını gösterir. Konuşulma hacmi ise seçilen sorgu içinde markadan bahseden yakalanmış paylaşım sayısıdır. Bu ikisini ayrı raporlamak şart: markanın ürettiği gönderilerle kullanıcıların ürettiği konuşmalar tamamen farklı şeyler anlatır.
hacim = (df.groupby(["marka", "gun"])
           .size().rename("paylasim_sayisi").reset_index())

toplam = (df.groupby("marka")
            .agg(paylasim=("metin", "size"),
                 toplam_etkilesim=("etkilesim", "sum"))
            .sort_values("paylasim", ascending=False))
print(toplam)
Ham hacim; marka bilinirliği, kampanya harcaması, takipçi tabanı ve platform erişiminden etkilenir. Hacim artışı tek başına olumlu algı ya da başarı anlamına gelmez — olumsuz bir olay da konuşulma hacmini kolayca ikiye katlar.
3. Etkileşimi adil karşılaştırın
Toplam etkileşim, büyük takipçi kitlesi olan ya da daha sık paylaşım yapan markayı doğal olarak öne çıkarır. Mümkünse erişim veya takipçi başına oranları hesaplayın; paylaşım türünü ve platformu da ayrı değerlendirin.
# Erişim varsa: erişim başına etkileşim daha açıklayıcıdır
df["erisim_orani"] = df["etkilesim"] / df["erisim"].where(df["erisim"] > 0)

# Erişim yoksa takipçi sayısı yaklaşık payda olarak kullanılabilir
df["takipci_orani"] = df["etkilesim"] / df["takipci"].where(df["takipci"] > 0)

ozet = (df.groupby(["marka", "platform"])
          .agg(ortalama_erisim_orani=("erisim_orani", "mean"),
               ortanca_etkilesim=("etkilesim", "median"),
               paylasim=("etkilesim", "size")))
print(ozet.round(4))
where(... > 0) kullanımı sıfıra bölmeyi engeller ve o satırları NaN yapar; böylece oranlar sessizce sonsuza gitmez. Ortalama tek bir viral gönderiden ciddi biçimde etkilenebileceği için medyanı da birlikte raporlayın. Ve en önemlisi: erişim başına oran ile takipçi başına oran aynı şey değildir, ikisini aynı tabloda yan yana koymayın.
4. Duygu dağılımını yorumlayın
Duygu analizi metinleri çoğunlukla olumlu, nötr ve olumsuz sınıflara ayırır. Sınıflandırıcılar ironi, argo, emoji, bağlam, çok dilli kullanım ve marka adlarını yanlış okuyabilir. Skor, kamuoyunun kusursuz ölçümü değil, incelenmesi gereken yaklaşık bir göstergedir.
# duygu sütununun pozitif / nötr / negatif etiketleri içerdiğini varsayalım
duygu_sayisi = pd.crosstab(df["marka"], df["duygu"])
duygu_yuzde = pd.crosstab(df["marka"], df["duygu"], normalize="index") * 100

print(duygu_sayisi)
print(duygu_yuzde.round(1))
Yüzdeleri her zaman örnek sayısıyla birlikte paylaşın. 40 paylaşımda %70 olumlu ile 4.000 paylaşımda %70 olumlu aynı güvende değildir. Otomatik etiketlerin bir bölümünü elle gözden geçirin: hem model hatalarını görürsünüz hem de hangi konuların hangi tonu çektiğini anlarsınız.
5. Konuşulma payı ve zaman içindeki değişim
Paylaşımların aynı izleme kapsamından geldiği varsayımıyla konuşulma payı, markanın toplam marka konuşmaları içindeki hacim oranıdır. Pazar payı ya da satın alma tercihiyle karıştırılmamalıdır. Günlük veya haftalık seri ise kampanya ve kriz sıçramalarını görünür kılar.
marka_hacmi = df.groupby("marka").size()
konusulma_payi = marka_hacmi / marka_hacmi.sum() * 100
print(konusulma_payi.round(1))

gunluk = (df.groupby(["gun", "marka"]).size()
            .rename("hacim").reset_index())
Paydanın hangi markaları ve hangi paylaşımları kapsadığını mutlaka belirtin. Tek bir rakibin sorgudan çıkarılması bile tüm payları değiştirir. Botlar, kopyala-yapıştır tekrarlar ve tek bir viral gönderi de hacmi kolayca şişirir.
6. Görseller ve karşılaştırma tablosu
Önce ortak tarih aralığında hacim eğilimini, ardından platforma göre etkileşim oranını ve duygu dağılımını gösterin. Eksenleri, paydaları ve birimleri etiketleyin; ham sayılarla oranları asla aynı grafikte karıştırmayın.
import seaborn as sns
import matplotlib.pyplot as plt

sns.lineplot(data=gunluk, x="gun", y="hacim", hue="marka")
plt.title("Günlük marka konuşulma hacmi")
plt.xlabel("Tarih"); plt.ylabel("Paylaşım sayısı")
plt.xticks(rotation=30)
plt.tight_layout()
plt.savefig("cikti/gunluk_hacim.png", dpi=160)
plt.close()| Ölçüt | Ne anlatır? | Yorum sınırı |
|---|---|---|
| Paylaşım sayısı | Yayımlanan içerik adedi | Kalite ve erişim ölçmez |
| Etkileşim oranı | Erişim veya takipçiye göre tepki | Payda ve platform tanımı belirleyici |
| Duygu dağılımı | Metinlerdeki sınıflandırılmış ton | Model hatası ve bağlam etkisi |
| Konuşulma hacmi | İzlenen sorguda marka bahsi | Bilinirlik veya başarıyla aynı değil |
| Konuşulma payı | Seçilen markalar arasındaki hacim payı | İzleme kapsamına çok duyarlı |
7. Bulguyu karara dönüştürün
- Soruyu
Sabitle - Sorguyu
Doğrula - Ham ve Oranlı
Ölçüler - Değişimleri
Bağlamlandır - İhtiyatla
İfade Et
- Soruyu ve dönemi sabitleyin: aynı platform kapsamı, aynı tarih aralığı.
- Veri sorgusunu doğrulayın: marka adı, yazım varyantları, spam ve tekrarlar.
- Ham ve normalize ölçüleri yan yana verin: hacim, oran ve örneklem büyüklüğü birlikte.
- Değişimleri bağlamlandırın: kampanya, ürün duyurusu, kriz ve platform algoritma değişiklikleri.
- Sonucu ihtiyatla ifade edin: gözlemi nedensel iddiadan ayırın.
Kontrol listesi
Soru net mi?
Hangi metriğe göre karşılaştırdığınızı raporun başında yazın.
Kapsam eşit mi?
Tarih aralığı ve platform listesi iki marka için birebir aynı olmalı.
Sorgu doğrulandı mı?
Marka adı çakışmalarını örnek paylaşımlar üzerinden elle kontrol edin.
Spam kuralları
Bot, tekrar ve yeniden paylaşım kuralları önceden tanımlı ve yazılı olsun.
Payda gösterildi mi?
Her oranın paydası ve örnek sayısı tabloda görünmeli.
Sınırlar yazıldı mı?
Model hatası, örneklem yanlılığı ve kapsam kısıtları raporda yer alsın.
Tek bir lider tablosu yeterli değil
Sosyal medya marka karşılaştırması tek bir sıralamadan ibaret değildir. Hacim görünürlüğü, oranlar etkileşim kalitesini, duygu dağılımı ise metinlerdeki yaklaşık tonu gösterir. Üçü farklı soruları yanıtlar ve çoğu zaman farklı markayı öne çıkarır.
Birden çok ölçüyü aynı kapsamda, paydalarıyla ve bağlamıyla sunmak hem daha adil hem de karar verirken daha işe yarar bir değerlendirme sağlar. “A markası önde” cümlesi, hangi metrikte ve hangi kapsamda önde olduğu yazılmadığı sürece bir bulgu değildir.
What should the comparison answer?
“Which brand is better?” is not on its own a measurable question. Is one talked about more, does it get higher engagement, or is the tone of its conversations more positive? Those three questions need different metrics, different denominators and different readings.
Use the same date range, comparable platform coverage and consistent brand queries. A brand name clashing with a common word, other products sharing the name, or usernames will pollute the results; always validate your queries against sample posts.
1. Prepare the data
For every post, store brand, platform, time, text, engagement counts and — where available — reach or impressions consistently. Decide the rules for deduplication, language detection, spam filtering and how reshares are handled before you start.
import pandas as pd

df = pd.read_csv("veri/sosyal_paylasimlar.csv", parse_dates=["tarih"])

df["marka"] = df["marka"].str.strip().str.casefold()
df["etkilesim"] = df[["begeni", "yorum", "paylasim"]].fillna(0).sum(axis=1)
df["gun"] = df["tarih"].dt.date

print(df.groupby("marka").size())
print(df[["platform", "tarih", "marka"]].isna().sum())
casefold() normalises a little more aggressively than lower() (it maps the German ß to ss, for instance) and is the better choice for caseless matching. But note: neither is locale-aware. In Python "I".casefold() returns "i", not the Turkish "ı". If Turkish case differences matter in your brand names, you have to handle that separately. Note too that summing likes, comments and shares into one engagement figure assumes they weigh the same; if you use different weights, state the formula in the report.
2. Post count and conversation volume
A brand's own post count shows how much content it published. Conversation volume is the number of captured posts mentioning the brand within your query. Report the two separately: content the brand produced and conversation users produced tell entirely different stories.
hacim = (df.groupby(["marka", "gun"])
           .size().rename("paylasim_sayisi").reset_index())

toplam = (df.groupby("marka")
            .agg(paylasim=("metin", "size"),
                 toplam_etkilesim=("etkilesim", "sum"))
            .sort_values("paylasim", ascending=False))
print(toplam)
Raw volume is shaped by brand awareness, campaign spend, follower base and platform reach. A rise in volume does not by itself mean positive perception or success — a negative incident doubles conversation volume just as easily.
3. Compare engagement fairly
Total engagement naturally favours the brand with the larger follower base or the one that posts more often. Where you can, compute rates per reach or per follower, and assess post type and platform separately.
# If reach is available, engagement per reach is more informative
df["erisim_orani"] = df["etkilesim"] / df["erisim"].where(df["erisim"] > 0)

# Without reach, follower count can serve as an approximate denominator
df["takipci_orani"] = df["etkilesim"] / df["takipci"].where(df["takipci"] > 0)

ozet = (df.groupby(["marka", "platform"])
          .agg(ortalama_erisim_orani=("erisim_orani", "mean"),
               ortanca_etkilesim=("etkilesim", "median"),
               paylasim=("etkilesim", "size")))
print(ozet.round(4))
where(... > 0) prevents division by zero by turning those rows into NaN, so rates do not quietly run to infinity. Report the median alongside the mean, since a single viral post can distort the average badly. And most importantly: engagement per reach and engagement per follower are not the same thing — never put them side by side in one table.
4. Interpret the sentiment split
Sentiment analysis usually sorts text into positive, neutral and negative. Classifiers misread irony, slang, emoji, context, multilingual usage and brand names. The score is not a flawless measure of public opinion but an approximate indicator that needs examining.
# assuming the sentiment column holds positive / neutral / negative labels
duygu_sayisi = pd.crosstab(df["marka"], df["duygu"])
duygu_yuzde = pd.crosstab(df["marka"], df["duygu"], normalize="index") * 100

print(duygu_sayisi)
print(duygu_yuzde.round(1))
Always publish percentages together with the sample size. 70% positive across 40 posts does not carry the same confidence as 70% across 4,000. Review a portion of the automatic labels by hand: you will see both the model's errors and which topics attract which tone.
5. Share of voice and change over time
Assuming all posts come from the same monitoring scope, share of voice is a brand's share of total brand conversation by volume. It must not be confused with market share or purchase preference. A daily or weekly series makes campaign and crisis spikes visible.
marka_hacmi = df.groupby("marka").size()
konusulma_payi = marka_hacmi / marka_hacmi.sum() * 100
print(konusulma_payi.round(1))

gunluk = (df.groupby(["gun", "marka"]).size()
            .rename("hacim").reset_index())
State exactly which brands and which posts the denominator covers. Removing a single competitor from the query changes every share. Bots, copy-paste repetition and one viral post inflate volume just as easily.
6. Charts and a comparison table
Show the volume trend over the shared date range first, then the engagement rate by platform and the sentiment split. Label axes, denominators and units; never mix raw counts and rates in the same chart.
import seaborn as sns
import matplotlib.pyplot as plt

sns.lineplot(data=gunluk, x="gun", y="hacim", hue="marka")
plt.title("Daily brand conversation volume")
plt.xlabel("Date"); plt.ylabel("Posts")
plt.xticks(rotation=30)
plt.tight_layout()
plt.savefig("cikti/gunluk_hacim.png", dpi=160)
plt.close()| Metric | What it shows | Limit of interpretation |
|---|---|---|
| Post count | Volume of content published | Measures neither quality nor reach |
| Engagement rate | Response relative to reach or followers | Denominator and platform definition decide it |
| Sentiment split | Classified tone in the text | Model error and context effects |
| Conversation volume | Brand mentions within the tracked query | Not the same as awareness or success |
| Share of voice | Volume share among the chosen brands | Highly sensitive to monitoring scope |
7. Turn the finding into a decision
- Fix the
Question - Validate the
Query - Raw and
Rate Measures - Contextualise
Changes - State It
Carefully
- Fix the question and the period: the same platform coverage, the same date range.
- Validate the query: brand name, spelling variants, spam and duplicates.
- Give raw and normalised measures side by side: volume, rate and sample size together.
- Contextualise the changes: campaigns, product announcements, crises and platform algorithm shifts.
- State the conclusion carefully: separate observation from causal claim.
A checklist
Is the question clear?
State at the top of the report which metric the comparison rests on.
Is coverage equal?
Date range and platform list must be identical for both brands.
Query validated?
Check brand-name clashes by hand against sample posts.
Spam rules
Bot, duplicate and reshare rules should be defined and written down in advance.
Denominator shown?
Every rate's denominator and sample size belong in the table.
Limits stated?
Model error, sampling bias and scope constraints should appear in the report.
One leaderboard is not enough
Comparing brands on social media is not a single ranking. Volume shows visibility, rates show engagement quality, and the sentiment split shows the approximate tone of the text. The three answer different questions and often put a different brand in front.
Presenting several measures within the same scope, with their denominators and their context, makes for a fairer and far more usable assessment. “Brand A is ahead” is not a finding until you have written down on which metric and within which scope.