R ile Veri Temizleme: dplyr ve tidyr Kullanımı
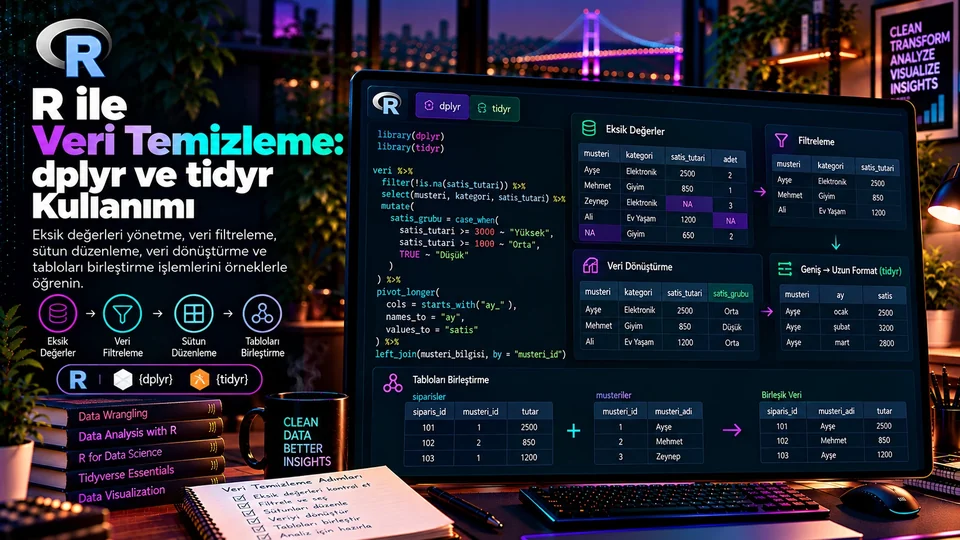
Analize başlamadan önce veriyi güvenilir ve tutarlı hâle getirmek gerekir. Eksik değerlerden tip dönüşümlerine, tekrar kayıtlardan tablo birleştirmeye kadar yaygın temizleme adımlarını gerçekçi R kodlarıyla ele alıyorum.
- Araçlar
Veri temizleme neden kritik?
Veri temizleme, yalnızca boş hücreleri silmek değildir. Amaç; veri yapısını anlamak, iş kurallarına uymayan kayıtları belirlemek, veri tiplerini düzeltmek ve analiz boyunca korunması gereken bilgiyi kaybetmeden tutarlı bir tablo oluşturmaktır.
Örneğin sosyal medya raporunda aynı marka adı “Marka A”, “marka a” ve “MARKA A” olarak geçiyorsa gruplama sonuçları bölünür. Tarihler karakter olarak tutuluyorsa dönemsel analizler yanlış sonuç verir. Birleştirme anahtarları benzersiz değilse satır sayısı beklenmedik biçimde artar.
- Veriyi
Tanı - Temizle
- Doğrula
- Analize
Hazırla
Gerekli paketler
dplyr satır ve sütun işlemleri ile birleştirmeleri; tidyr ise veriyi uzun/geniş forma dönüştürme ve dağınık hücreleri düzenleme işlerini kolaylaştırır. İkisi de tidyverse ekosisteminin parçasıdır.
install.packages("tidyverse")   # yalnızca ilk kurulumda
library(tidyverse)
Temizlemeden önce veriyi tanıyın
İlk adım, verinin boyutunu, sütun tiplerini ve örnek kayıtlarını incelemektir. Veriyi tanımadan yapılan otomatik düzeltmeler, geçerli kayıtların silinmesine veya anlamın bozulmasına yol açar.
glimpse(df)
dim(df)
names(df)
head(df, 10)
summary(df)

# Her sütundaki NA sayısı
df |>
  summarise(across(everything(),
                   ~ sum(is.na(.x))))
glimpse() sütun tiplerini ve örnek değerleri hızlıca gösterir. summary() sayısal alanların dağılımını, kategorik alanların ise frekans özetini anlamaya yardımcı olur.
Eksik değerleri yönetme
R, eksik değerleri NA ile temsil eder. Eksik verinin neden oluştuğunu anlamak, hangi yöntemin seçileceğini belirler. Bir değişkende eksiklik rastgele olabilir, belirli bir kullanıcı grubunda yoğunlaşabilir veya veri toplama sürecindeki bir sorundan kaynaklanabilir.
Eksik değerleri sayma ve filtreleme
# Belirli sütun için eksik kayıt sayısı
sum(is.na(df$puan))

# Puanı dolu olan kayıtlar
df |>
  filter(!is.na(puan))

# Seçilen sütunların tamamı dolu olan kayıtlar
df |>
  drop_na(marka, tarih, puan)
drop_na(marka, tarih, puan) yalnızca bu üç sütundan en az biri eksik olan satırları dışarıda bırakır. Argüman verilmeden drop_na() kullanılırsa herhangi bir sütununda eksik değer bulunan satırlar elenir; bu işlem veri kaybını ciddi ölçüde artırır.
Eksikleri doldurmak
# Metin alanındaki NA değerlerini etiketle
df |>
  mutate(kanal = replace_na(kanal, "Bilinmiyor"))

# Önceki gözlemi taşıma: sıralama çok önemlidir
df |>
  arrange(musteri_id, tarih) |>
  group_by(musteri_id) |>
  fill(segment, .direction = "down") |>
  ungroup()
fill() kullanırken önce arrange() ile doğru sıralamayı, sonra group_by() ile doğru sınırı kurmak zorunludur. Gruplama yapılmazsa bir müşterinin son bilinen segmenti, sıradaki başka bir müşterinin satırına taşınır.
Sayısal eksikleri ortalama veya medyan ile doldurmak bazı senaryolarda işe yarar; ancak dağılımı daraltır ve değişkenler arası ilişkileri çarpıtır. Doldurma yöntemi analitik amaca, eksikliğin nedenine ve değişkenin anlamına göre seçilmelidir. “Bilinmiyor” da gerçek bir kategori değil, veri kalitesi işareti olabilir.
Satırları filtreleme ve sıralama
filter() koşulları sağlayan kayıtları tutar. Birden fazla koşulda & “ve”, | “veya” anlamına gelir. Eksik değerler koşul değerlendirmesinde özel dikkat gerektirir.
# Puan eşiği
df |>
  filter(puan >= 70)

# Birden fazla kanal
df |>
  filter(kanal %in% c("Instagram", "YouTube"))

# Tarihe göre sıralama
df |>
  arrange(desc(tarih), marka)
filter(puan >= 70) ifadesi, puanı NA olan satırları sonuçta tutmaz: koşulun sonucu NA olduğunda satır seçilmez. Bu davranış genellikle istenendir, ama sessizdir. İş kuralı açısından eksik puanların ayrıca raporlanması gerekiyorsa bunları filtrelemeden önce ayrı bir kontrolle saymak iyi uygulamadır.
Sütun seçme, yeniden adlandırma ve dönüştürme
select() analize gerekli sütunları seçer, rename() adları değiştirir, mutate() yeni değişken üretir veya mevcut değişkenleri dönüştürür.
temiz_df <- df |>
  select(kayit_id, marka, tarih, puan, kanal) |>
  rename(record_id = kayit_id,
         score     = puan) |>
  mutate(
    marka = str_squish(str_to_title(marka)),
    tarih = as.Date(tarih),
    score = as.numeric(score),
    puan_grubu = case_when(
      score >= 80          ~ "Yüksek",
      score >= 50          ~ "Orta",
      !is.na(score)      ~ "Düşük",
      TRUE                ~ "Eksik"
    )
  )
case_when() koşulları yukarıdan aşağıya değerlendirir ve ilk sağlanan koşulda durur. Son satırdaki TRUE yakalama kuralıdır; burada yalnızca score değeri NA olan satırlar oraya düşer, çünkü üçüncü koşul eksik olmayan tüm düşük puanları zaten almıştır.
Bu örnek, giriş sütunlarının uygun tiplerde olduğunu varsayar. Özellikle sayısal sütunda “yok”, “-” veya para birimi işaretleri varsa as.numeric() bunları sessizce NA yapar. Dönüşümden önce beklenmeyen değerleri kontrol edin.
Karakter verisini güvenli biçimde temizleme
df |>
  mutate(
    marka  = str_squish(marka),
    marka  = str_to_lower(marka),
    eposta = str_trim(eposta)
  )
str_squish() baştaki ve sondaki boşlukları kaldırır, aradaki tekrarlı boşlukları teke indirir; str_trim() yalnızca uçlardaki boşlukları alır. Ancak her metin alanını küçük harfe çevirmek doğru değildir: özel kodlar, dosya adları veya büyük/küçük harfe duyarlı tanımlayıcılar bu işlemden zarar görür.
str_to_lower() ve str_to_upper() çalıştıkları yerel ayara (locale) duyarlıdır. “I” harfinin küçüğü Türkçede “ı”, İngilizcede “i”dir. Marka adlarını normalize ederken beklenmedik eşleşme hatalarıyla karşılaşmamak için locale argümanını bilinçli seçin.Yinelenen kayıtları kontrol etme
Tekrar kayıt, veri setindeki iş tanımına göre değerlendirilmelidir. Aynı satırın birebir tekrarı ile aynı müşterinin birden fazla işlem yapması aynı şey değildir. Önce tablonun “bir satır neyi temsil ediyor?” sorusunu cevaplayın.
# Birebir aynı satırları say
sum(duplicated(df))

# İş anahtarı varsayımı: kayıt kimliği benzersiz olmalı
df |>
  count(kayit_id) |>
  filter(n > 1)

# İş kuralı doğrulandıktan sonra benzersiz satırları tut
df |>
distinct()distinct() uygulamayın. Aynı müşterinin aynı gün iki ayrı işlem yapması meşru olabilir. Hangi alanların benzersiz olması gerektiğini veri sözlüğü veya iş kuralı belirlemelidir; kod değil.tidyr ile veriyi düzenleme
Analiz araçları çoğu zaman her değişkenin ayrı sütunda, her gözlemin ayrı satırda olduğu “tidy data” yapısından yararlanır. tidyr, verinin geniş ve uzun biçimleri arasında geçiş yapmayı ve bir hücreye sıkışmış bilgileri ayırmayı sağlar.
Geniş formdan uzun forma: pivot_longer()
Her ayın ayrı sütunda tutulduğu bir rapor tablosunu düşünelim. Grafik çizimi veya dönemsel karşılaştırma için ay ve değer sütunlarına dönüştürmek daha esnektir.
aylik <- tibble(
  marka = c("A", "B"),
  ocak  = c(120, 90),
  subat = c(135, 110),
  mart  = c(150, 105)
)

uzun <- aylik |>
  pivot_longer(
    cols      = ocak:mart,
    names_to  = "ay",
    values_to = "mention_sayisi"
  )
Uzun formdan geniş forma: pivot_wider()
genis <- uzun |>
  pivot_wider(
    names_from  = ay,
    values_from = mention_sayisi
  )
pivot_wider() kullanırken her marka-ay kombinasyonunun tek bir değere karşılık gelip gelmediğini kontrol edin. Aynı anahtar için birden fazla kayıt varsa tidyr hücreye liste yerleştirir ve uyarı verir; bu durumda values_fn ile bir özetleme fonksiyonu vermeniz ya da veriyi önceden toplulaştırmanız gerekir.
Bir sütunu bölme ve birleştirme
kodlar <- tibble(kod = c("TR-IST-01", "TR-ANK-02"))

ayrik <- kodlar |>
  separate_wider_delim(
    kod, delim = "-",
    names = c("ulke", "sehir", "sube")
  )

birlesik <- ayrik |>
  unite(tam_kod, ulke, sehir, sube, sep = "-")
separate_wider_delim() güncel tidyr sürümlerinde ayırıcıya göre sütunları böler; eski projelerde separate() fonksiyonuna rastlayabilirsiniz. Ayırıcı metnin kendi içinde de bulunabiliyorsa önce biçimi doğrulayın, çünkü beklenen parça sayısı her kayıtta aynı olmayabilir. too_few ve too_many argümanları bu durumlarda ne yapılacağını açıkça belirtmenizi sağlar.
dplyr ile tabloları birleştirme
Birleştirme işlemleri, kayıtları ortak anahtarlar üzerinden ilişkilendirir. Doğru birleştirme için anahtar sütunlarının anlamı, veri tipleri ve benzersizlik düzeyi anlaşılmalıdır.
| Fonksiyon | Ne yapar? | Tipik kullanım |
|---|---|---|
left_join() | Sol tablodaki tüm kayıtları korur. | Ana tabloya boyut veya açıklama bilgisi ekleme. |
inner_join() | Yalnızca iki tabloda eşleşen kayıtları tutar. | Her iki kaynakta da bulunan kayıtlarla çalışma. |
full_join() | İki tablodaki tüm kayıtları korur. | Kaynaklar arasındaki eşleşmeyen kayıtları inceleme. |
anti_join() | İlk tabloda olup ikincide eşleşmeyenleri verir. | Eksik eşleşmeleri ve anahtar sorunlarını bulma. |
paylasimlar <- tibble(
  marka_id = c(1, 2, 3),
  mention  = c(120, 85, 43)
)
markalar <- tibble(
  marka_id  = c(1, 2, 3),
  marka_adi = c("A", "B", "C")
)

# Sağ tablonun anahtarının benzersiz olduğunu doğrula
markalar |>
  count(marka_id) |>
  filter(n > 1)

sonuc <- paylasimlar |>
  left_join(markalar, by = "marka_id")
Sağ tabloda aynı marka_id birden çok kez bulunursa tek bir paylaşım kaydı birden fazla satırla eşleşir ve sonuç tablosu sessizce büyür. Bu, birleştirmelerde en sık yapılan hatadır. Güncel dplyr sürümlerinde beklenen ilişkiyi relationship argümanıyla açıkça belirtebilirsiniz; böylece varsayımınız bozulduğunda kod hata verir.
paylasimlar |>
  anti_join(markalar, by = "marka_id")
Bu çıktı, paylaşım tablosunda bulunan fakat marka tablosunda karşılığı olmayan anahtarları gösterir. Sonuç boş değilse nedeni eksik referans kaydı, farklı veri tipi (bir tarafta metin, diğerinde sayı), baştaki veya sondaki boşluk ya da farklı karakter kodlaması olabilir.
Uçtan uca temizleme akışı
Aşağıdaki örnek, gerçek projede kullanılabilecek bir işlem sırasını gösterir. Varsayım: raw_df içinde kayit_id, marka, tarih, puan ve kanal sütunları bulunuyor; tarih değerleri ISO biçiminde (YYYY-MM-DD), puanlar ise sayısal veya sayıya dönüştürülebilir değerlerden oluşuyor.
clean_df <- raw_df |>
  mutate(
    marka = str_squish(marka),
    kanal = str_squish(kanal),
    tarih = as.Date(tarih),
    puan  = as.numeric(puan)
  ) |>
  filter(
    !is.na(kayit_id),
    !is.na(tarih)
  ) |>
  distinct() |>
  mutate(
    marka = na_if(marka, ""),
    kanal = replace_na(kanal, "Bilinmiyor")
  )
Bu bir başlangıç şablonudur. distinct() yalnızca birebir aynı satırları kaldırır, iş anahtarı bazlı tekilleştirme yapmaz. as.numeric() ise metin biçimindeki sayılarda uyarı üretip NA döndürebilir. Dönüşüm öncesi ve sonrası eksik değer sayılarını karşılaştırın; Türkiye biçimindeki ondalık virgüller için uygun yerel ayar ya da kontrollü karakter dönüşümü gerekir.
Kalite kontrolleri ekleyin
# Temizleme öncesi ve sonrası satır sayısı
nrow(raw_df)
nrow(clean_df)

# Tipler ve eksikler
glimpse(clean_df)
clean_df |>
  summarise(across(everything(),
                   ~ sum(is.na(.x))))

# Puan aralığı iş kuralına uygun mu?
clean_df |>
  filter(!is.na(puan), puan < 0 | puan > 100)
Son örnekteki 0–100 aralığı yalnızca puan değişkeni gerçekten bu ölçeği kullanıyorsa geçerlidir. Veri doğrulama kuralları her zaman alanın iş anlamına dayanmalıdır; genel geçer eşikler değil.
Yaygın hatalar için kontrol listesi
Satırın anlamı
Her satırın neyi temsil ettiğini ve benzersiz anahtarın ne olduğunu en başta tanımlayın.
Eksikler
Silmeden önce eksik değerlerin sayısını, oranını ve olası nedenlerini inceleyin.
Tipler
Metin, tarih ve sayısal sütunların tiplerini kontrol edin; başarısız dönüşümleri takip edin.
Anahtarlar
Birleştirmeden önce anahtarların benzersizliğini ve iki tablodaki veri tiplerini karşılaştırın.
Satır sayısı
Filtreleme, tekilleştirme ve birleştirme sonrasında satır sayısını yeniden doğrulayın.
İzlenebilirlik
Adımları betik hâlinde saklayın, ham veriyi değiştirmeden koruyun ve kararları belgeleyin.
Temiz veri, güvenilir analiz
dplyr ile satırları filtreleyebilir, sütunları düzenleyebilir, yeni değişkenler üretebilir ve tabloları anahtarlar üzerinden birleştirebilirsiniz. tidyr ise geniş ve uzun veri biçimleri arasında geçiş yapmanızı, hücrelere sıkışmış bilgileri ayrıştırmanızı sağlar.
En iyi sonuç, fonksiyonları ezberlemekten çok verinin yapısını anlamakla elde edilir. Her dönüşümün gerekçesini açıklayın, veri kaybını ölçün ve temizlenmiş veriyi analize almadan önce doğrulayın. Temizleme adımlarının çoğu geri alınamaz; bu yüzden ham veriyi her zaman olduğu gibi saklayın.
Why does data cleaning matter?
Data cleaning is not just deleting empty cells. The aim is to understand the structure of the data, identify records that break business rules, fix data types, and build a consistent table without losing information you need later in the analysis.
If the same brand appears as “Brand A”, “brand a” and “BRAND A” in a social media report, your grouped results split apart. If dates are stored as text, period comparisons give the wrong answer. If join keys are not unique, the row count grows unexpectedly.
- Profile
the Data - Clean
- Validate
- Prepare for
Analysis
The packages you need
dplyr handles row and column operations and joins; tidyr makes it easier to move data between long and wide forms and to tidy up crowded cells. Both are part of the tidyverse.
install.packages("tidyverse")   # only on first install
library(tidyverse)
Profile the data before you clean it
The first step is to inspect the size of the data, the column types and a few example records. Automatic fixes applied without knowing the data lead to valid records being deleted or meaning being destroyed.
glimpse(df)
dim(df)
names(df)
head(df, 10)
summary(df)

# Number of NAs in each column
df |>
  summarise(across(everything(),
                   ~ sum(is.na(.x))))
glimpse() quickly shows column types and sample values. summary() helps you understand the distribution of numeric fields and the frequencies of categorical ones.
Handling missing values
R represents missing values with NA. Understanding why the data is missing determines which method you should choose. Missingness in a variable can be random, concentrated in a particular user group, or caused by a problem in the collection process.
Counting and filtering missing values
# Missing records in one column
sum(is.na(df$puan))

# Records where the score is present
df |>
  filter(!is.na(puan))

# Records complete across the selected columns
df |>
  drop_na(marka, tarih, puan)
drop_na(marka, tarih, puan) drops only the rows where at least one of those three columns is missing. Called without arguments, drop_na() removes every row with a missing value in any column, which can increase data loss dramatically.
Filling the gaps
# Label NA values in a text field
df |>
  mutate(kanal = replace_na(kanal, "Unknown"))

# Carrying the previous observation forward: order matters
df |>
  arrange(musteri_id, tarih) |>
  group_by(musteri_id) |>
  fill(segment, .direction = "down") |>
  ungroup()
When using fill() you must first set the right order with arrange() and then the right boundary with group_by(). Without grouping, one customer's last known segment is carried into the next customer's row.
Filling numeric gaps with the mean or median works in some scenarios, but it narrows the distribution and distorts relationships between variables. The method should follow the analytical goal, the reason for the missingness and the meaning of the variable. “Unknown” may not be a real category either — it can be a data quality marker.
Filtering and sorting rows
filter() keeps the records that satisfy your conditions. With several conditions, & means “and” and | means “or”. Missing values need special attention when conditions are evaluated.
# Score threshold
df |>
  filter(puan >= 70)

# Several channels
df |>
  filter(kanal %in% c("Instagram", "YouTube"))

# Sorting by date
df |>
  arrange(desc(tarih), marka)
filter(puan >= 70) does not keep rows where the score is NA: when a condition evaluates to NA, the row is not selected. That behaviour is usually what you want, but it is silent. If the business rule requires missing scores to be reported separately, count them in a dedicated check before filtering.
Selecting, renaming and transforming columns
select() picks the columns the analysis needs, rename() changes names, and mutate() creates new variables or transforms existing ones.
temiz_df <- df |>
  select(kayit_id, marka, tarih, puan, kanal) |>
  rename(record_id = kayit_id,
         score     = puan) |>
  mutate(
    marka = str_squish(str_to_title(marka)),
    tarih = as.Date(tarih),
    score = as.numeric(score),
    puan_grubu = case_when(
      score >= 80          ~ "High",
      score >= 50          ~ "Medium",
      !is.na(score)      ~ "Low",
      TRUE                ~ "Missing"
    )
  )
case_when() evaluates its conditions top to bottom and stops at the first match. The final TRUE is the catch-all; here only rows where score is NA fall through to it, because the third condition has already taken every non-missing low score.
This example assumes the input columns have suitable types. If a numeric column contains “none”, “-” or currency symbols, as.numeric() silently turns them into NA. Check for unexpected values before converting.
Cleaning character data safely
df |>
  mutate(
    marka  = str_squish(marka),
    marka  = str_to_lower(marka),
    eposta = str_trim(eposta)
  )
str_squish() removes leading and trailing whitespace and collapses repeated inner spaces into one; str_trim() only takes the ends. But lowercasing every text field is not right: special codes, file names and case-sensitive identifiers are damaged by it.
str_to_lower() and str_to_upper() are locale-sensitive. The lowercase of “I” is “ı” in Turkish and “i” in English. When normalising brand names, choose the locale argument deliberately to avoid surprising match failures.Checking for duplicate records
Duplicates must be judged against the business definition of the dataset. An exact repeat of the same row is not the same thing as one customer making several transactions. Answer the question “what does one row represent?” first.
# Count exactly repeated rows
sum(duplicated(df))

# Business key assumption: the record ID should be unique
df |>
  count(kayit_id) |>
  filter(n > 1)

# Keep unique rows once the rule is confirmed
df |>
distinct()distinct() before examining the duplicates. The same customer making two separate transactions on the same day may be entirely legitimate. A data dictionary or business rule decides which fields must be unique — not the code.Reshaping data with tidyr
Analysis tools usually benefit from “tidy data”, where each variable has its own column and each observation its own row. tidyr lets you move between wide and long forms and split information crammed into a single cell.
Wide to long: pivot_longer()
Think of a report table where every month sits in its own column. For plotting or period comparison, turning it into month and value columns is far more flexible.
aylik <- tibble(
  marka = c("A", "B"),
  ocak  = c(120, 90),
  subat = c(135, 110),
  mart  = c(150, 105)
)

uzun <- aylik |>
  pivot_longer(
    cols      = ocak:mart,
    names_to  = "ay",
    values_to = "mention_sayisi"
  )
Long to wide: pivot_wider()
genis <- uzun |>
  pivot_wider(
    names_from  = ay,
    values_from = mention_sayisi
  )
When using pivot_wider(), check whether every brand-month combination corresponds to a single value. If several records share a key, tidyr puts a list in the cell and warns you; you then need a summary function via values_fn, or you must aggregate beforehand.
Splitting and uniting a column
kodlar <- tibble(kod = c("TR-IST-01", "TR-ANK-02"))

ayrik <- kodlar |>
  separate_wider_delim(
    kod, delim = "-",
    names = c("ulke", "sehir", "sube")
  )

birlesik <- ayrik |>
  unite(tam_kod, ulke, sehir, sube, sep = "-")
separate_wider_delim() splits columns by a delimiter in current tidyr versions; in older projects you will meet separate(). If the delimiter can also appear inside the text, validate the format first, because the expected number of pieces may not be the same in every record. The too_few and too_many arguments let you state explicitly what should happen in those cases.
Joining tables with dplyr
Joins relate records through shared keys. For a correct join you need to understand the meaning of the key columns, their data types and their level of uniqueness.
| Function | What it does | Typical use |
|---|---|---|
left_join() | Keeps every record in the left table. | Adding dimension or descriptive data to a main table. |
inner_join() | Keeps only records matched in both tables. | Working with records present in both sources. |
full_join() | Keeps every record from both tables. | Inspecting unmatched records across sources. |
anti_join() | Returns rows in the first table with no match in the second. | Finding missing matches and key problems. |
paylasimlar <- tibble(
  marka_id = c(1, 2, 3),
  mention  = c(120, 85, 43)
)
markalar <- tibble(
  marka_id  = c(1, 2, 3),
  marka_adi = c("A", "B", "C")
)

# Confirm the right-hand key is unique
markalar |>
  count(marka_id) |>
  filter(n > 1)

sonuc <- paylasimlar |>
  left_join(markalar, by = "marka_id")
If the same marka_id appears more than once in the right-hand table, a single mention record matches several rows and the result quietly grows. This is the most common mistake in joins. Current dplyr versions let you state the expected cardinality with the relationship argument, so the code fails when your assumption breaks.
paylasimlar |>
  anti_join(markalar, by = "marka_id")
This output shows keys present in the mentions table with no counterpart in the brand table. If the result is not empty, the cause may be a missing reference record, a type mismatch (text on one side, number on the other), leading or trailing whitespace, or a different character encoding.
An end-to-end cleaning pipeline
The example below shows an order of operations you could use in a real project. The assumption: raw_df contains kayit_id, marka, tarih, puan and kanal; dates are in ISO format (YYYY-MM-DD) and scores are numeric or convertible to numbers.
clean_df <- raw_df |>
  mutate(
    marka = str_squish(marka),
    kanal = str_squish(kanal),
    tarih = as.Date(tarih),
    puan  = as.numeric(puan)
  ) |>
  filter(
    !is.na(kayit_id),
    !is.na(tarih)
  ) |>
  distinct() |>
  mutate(
    marka = na_if(marka, ""),
    kanal = replace_na(kanal, "Unknown")
  )
This is a starting template. distinct() only removes exactly identical rows; it does not deduplicate by business key. as.numeric() can raise warnings and return NA for numbers held as text. Compare missing-value counts before and after the conversion; decimal commas in Turkish-formatted data need an appropriate locale or a controlled character conversion.
Add quality checks
# Row counts before and after cleaning
nrow(raw_df)
nrow(clean_df)

# Types and missing values
glimpse(clean_df)
clean_df |>
  summarise(across(everything(),
                   ~ sum(is.na(.x))))

# Does the score respect the business range?
clean_df |>
  filter(!is.na(puan), puan < 0 | puan > 100)
The 0–100 range in that last example is valid only if the score variable really uses that scale. Validation rules should always rest on the business meaning of the field, never on generic thresholds.
A checklist for common mistakes
What a row means
Define at the outset what each row represents and what the unique key is.
Missing values
Before deleting, examine the count, the share and the likely causes of missingness.
Types
Check text, date and numeric column types, and track failed conversions.
Keys
Before joining, compare key uniqueness and data types across both tables.
Row counts
Re-verify the row count after filtering, deduplicating and joining.
Traceability
Keep the steps in a script, leave the raw data untouched, and document your decisions.
Clean data, trustworthy analysis
With dplyr you can filter rows, organise columns, derive new variables and join tables on keys. tidyr lets you move between wide and long formats and pull apart information crammed into cells.
The best results come from understanding the structure of the data rather than memorising functions. Explain the reason for every transformation, measure the data you lose, and validate the cleaned data before taking it into analysis. Most cleaning steps cannot be undone, so always keep the raw data exactly as it came.