Sosyal Medya Verileriyle Konu Modellemesi: Topic Modeling Nedir?
Binlerce paylaşımda hangi temalar tekrar ediyor? LDA'nın nasıl çalıştığını, Türkçe metinde ön işlemenin neden kritik olduğunu ve konu sayısına nasıl karar verildiğini Python ve R örnekleriyle anlatıyorum.
- Sosyal Medya
- Yapay Zeka
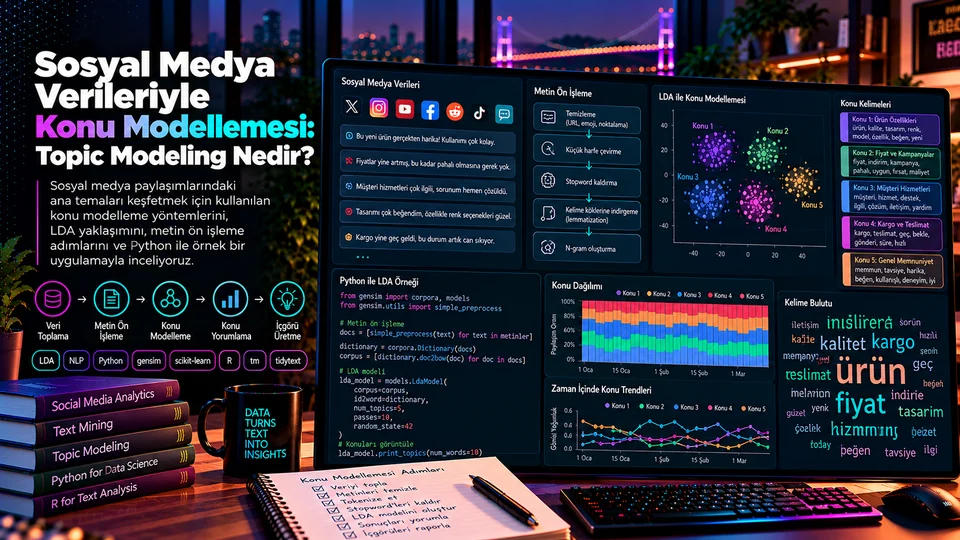
Topic modeling nedir?
Konu modelleme (topic modeling), bir metin koleksiyonunda birlikte görülme eğilimi gösteren kelimeleri kullanarak gizil konu yapıları keşfetmeye yönelik yöntemler ailesidir. Model, her metni bir veya birden fazla konu ile; her konuyu da kelimeler üzerinde bir olasılık dağılımıyla temsil eder.
Sosyal medya dinleme projelerinde konu modelleme; müşteri şikâyetlerini gruplamak, ürün özellikleri hakkında konuşulanları bulmak, kampanya geri bildirimlerini keşfetmek veya gündemdeki yeni temaları fark etmek için kullanılır. Geleneksel anahtar kelime aramasından farklı olarak, önceden her temanın kelime listesini yazmak zorunda kalmazsınız.
Anahtar kelime araması
Bilinen bir kelime veya ifade aranır. Açıkça tanımlanmış konular için hızlı ve denetlenebilir bir yöntemdir; ama yalnızca aradığınızı bulur.
Konu modelleme
Kelime örüntülerinden olası tema yapıları keşfedilir. Beklemediğiniz konuları bulabilir; buna karşılık sonuçların yorumlanması gerekir.
Sosyal medya analizinde nerelerde kullanılır?
- Müşteri deneyimi: Teslimat, fiyat, uygulama performansı, müşteri hizmetleri gibi tekrar eden temaları keşfetme.
- Marka itibarı: Marka hakkında hangi konuların konuşulduğunu ve bunların zaman içinde nasıl değiştiğini inceleme.
- Kampanya değerlendirmesi: Kampanya sonrası kullanıcıların hangi mesajlara, ürün özelliklerine veya deneyimlere odaklandığını anlama.
- Rakip analizi: Rakip markalarla ilgili konuşmaların konu dağılımlarını karşılaştırma.
- Gündem ve kriz izleme: Konu hacmindeki ani artışları erken fark edip uzman incelemesine yönlendirme.
Konu modelleme tek başına duygu analizi değildir. Bir modelin “teslimat” temasını bulması, o konuşmaların olumlu mu olumsuz mu olduğunu söylemez. İki yöntem birbirini tamamlar: konu modelleme neyin konuşulduğunu, duygu analizi nasıl konuşulduğunu verir.
LDA nasıl çalışır?
Latent Dirichlet Allocation (LDA), belgelerin birden fazla konu karışımından oluştuğunu ve her konunun kelimeler için bir olasılık dağılımı tanımladığını varsayan olasılıksal bir konu modelidir. Buradaki “belge”, sosyal medya analizinde tek bir paylaşım, yorum veya önceden belirlenmiş bir metin parçası olabilir.
- Belgeler
- Kelime
Matrisi - LDA
Modeli - Konu-Kelime
Dağılımları
İki temel dağılım
Konu → kelimeler
Bir konunun hangi kelimelerle temsil edildiğini gösterir. Örneğin “kargo”, “teslimat”, “kurye”, “sipariş”.
Belge → konular
Bir paylaşımın hangi konularla ne ölçüde ilişkili olduğunu gösterir. Tek paylaşım birden fazla konuya ait olasılık taşıyabilir.
LDA genellikle belge-kelime sayım matrisiyle çalışır. Bir belgede kelimenin kaç kez geçtiği önemlidir; kelime sırası standart LDA temsilinde doğrudan modellenmez. Bu nedenle deyimler, ironi ve bağlama çok bağlı ifadeler için yalnızca LDA yeterli olmaz.
Konu sayısı neden önemlidir?
Modeldeki konu sayısı önceden seçilir. Çok az konu farklı temaları birbirine karıştırır; çok fazla konu ise aynı temayı parçalara ayırır veya gürültü üretir. Konu sayısı; konu tutarlılığı (coherence), konu çeşitliliği, örnek belgelerin okunması ve analitik amaç birlikte değerlendirilerek seçilmelidir.
Metin ön işleme adımları
Konu modelinin kalitesi çoğu zaman algoritmadan önce metin hazırlığına bağlıdır. Sosyal medya verisi emoji, URL, kullanıcı etiketi, hashtag, yazım hatası, kısaltma, tekrar harf ve platforma özgü gürültü içerir. Her temizleme adımı amaca göre seçilmelidir; aşırı temizlik anlam taşıyan sinyalleri yok eder.
| Adım | Amaç | Dikkat |
|---|---|---|
| Veri filtreleme | Boş, yinelenen veya kapsam dışı kayıtları ayırmak. | Tekrar paylaşım gerçek yayılım göstergesi olabilir; otomatik silmeyin. |
| Küçük harfe dönüştürme | Kelime biçimlerinin parçalanmasını azaltmak. | Özel adlar ve kısaltmalar için bağlamı düşünün. |
| URL ve kullanıcı adı | Gereksiz değişken parçaları azaltmak. | URL veya hesap adı araştırma açısından anlamlı olabilir. |
| Tokenization | Metni kelime veya token birimlerine ayırmak. | Türkçe eklemeli bir dil; dil uyumlu araçlar seçin. |
| Stopword temizliği | Çok sık geçen, ayırt ediciliği düşük kelimeleri çıkarmak. | “değil”, “yok”, “çok” gibi kelimeler konu anlamını taşıyabilir. |
| Kök bulma / lemmatization | Aynı kelimenin farklı çekimlerini bir araya getirmek. | Türkçede yanlış kökler anlamsız konu kelimeleri üretir. |
| Birleşik ifadeler | “müşteri hizmetleri” gibi anlamlı kelime gruplarını korumak. | Bigram ve trigram seçeneklerini deneyin. |
Türkçe metinler için özel notlar
Türkçe eklemeli bir dil olduğundan “gel”, “geldi”, “gelmedi”, “gelecek” biçimleri yüzeyde farklı görünür. Basit kök kırpma her zaman doğru sonucu vermez. Türkçe destekli bir lemmatizer veya Zemberek gibi dil araçları değerlendirilebilir; ancak çıktı mutlaka örnekler üzerinden kontrol edilmelidir.
Olumsuzluk ifadelerini gelişigüzel kaldırmak da risklidir: “ürün iyi” ile “ürün iyi değil” arasındaki fark kaybolur. Konu modelleme duygu sınıflandırması yapmasa bile, bu tür kelimeler tema yorumunu doğrudan etkiler.
Python ile LDA konu modelleme örneği
Aşağıdaki örnek, yorum adlı sütunu bulunan bir CSV dosyası üzerinden temel bir LDA iş akışı gösterir. Kod öğretici olması için sadeleştirilmiştir; üretim ortamında Türkçe tokenization, alana özel stopword listesi, veri kalitesi kontrolleri ve model değerlendirmesi eklenmelidir.
1. Paketleri yükleme
pip install pandas scikit-learn2. Metni hazırlama ve belge-kelime matrisi
import re
import pandas as pd
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.decomposition import LatentDirichletAllocation

df = pd.read_csv("sosyal_medya_yorumlari.csv")
df = df.dropna(subset=["yorum"]).copy()
df["yorum"] = df["yorum"].astype(str)

def temizle(metin):
    metin = metin.lower()
    metin = re.sub(r"https?://\S+|www\.\S+", " ", metin)
    metin = re.sub(r"@\w+", " ", metin)
    metin = re.sub(r"[^a-zA-ZçğıöşüÇĞİÖŞÜ\s]", " ", metin)
    metin = re.sub(r"\s+", " ", metin).strip()
    return metin

df["temiz_yorum"] = df["yorum"].map(temizle)

stop_words_tr = [
    "ve", "veya", "ama", "ile", "bir",
    "bu", "şu", "çok", "daha", "için",
    "gibi", "mi", "mı", "de", "da"
]

vectorizer = CountVectorizer(
    stop_words=stop_words_tr,
    min_df=5,
    max_df=0.85,
    ngram_range=(1, 2)
)
X = vectorizer.fit_transform(df["temiz_yorum"])
min_df=5 en az beş belgede geçen terimleri tutar; max_df=0.85 belgelerin %85'inden fazlasında görülen çok yaygın terimleri dışarıda bırakır. Veri küçükse bu eşikler fazla agresif kalır. Gösterilen stopword listesi yalnızca örnektir; gerçek bir Türkçe projede alana özel kelimelerle genişletilmelidir.
3. LDA modelini eğitme
n_konu = 6

lda = LatentDirichletAllocation(
    n_components=n_konu,
    max_iter=20,
    learning_method="batch",
    random_state=42
)
doc_topic = lda.fit_transform(X)
kelimeler = vectorizer.get_feature_names_out()

def konu_kelimeleri(model, kelimeler, n=10):
    for i, dagilim in enumerate(model.components_):
        en_iyi = dagilim.argsort()[-n:][::-1]
        terimler = [kelimeler[j] for j in en_iyi]
        print(f"Konu {i + 1}: " + ", ".join(terimler))

konu_kelimeleri(lda, kelimeler, n=10)

df["baskin_konu"] = doc_topic.argmax(axis=1) + 1
df["konu_guveni"] = doc_topic.max(axis=1)
components_ içindeki değerler, kelimelerin konu içindeki ağırlıklarını temsil eden öğrenilmiş parametrelerdir; bunları doğrudan kalibre edilmiş olasılık gibi yorumlamamak gerekir. doc_topic ise her belgenin konu karışımını verir. En baskın konu etiketi kullanışlı bir özettir, ama bir belgenin birden fazla konu taşıyabileceğini gizler — konu_guveni sütununu bu yüzden tutuyoruz.
4. Konu sonuçlarını yorumlama
Model çıktısında konu 1 için “kargo, teslimat, sipariş, kurye”; konu 2 için “uygulama, giriş, hata, ekran” gibi kelimeler görünüyorsa bunlar sırasıyla teslimat ve uygulama deneyimi temaları olarak yorumlanabilir. Ancak konu adlarını algoritma vermez. Analist, kelimeleri ve o konuya yüksek olasılıkla atanan gerçek paylaşımları birlikte okuyarak isimlendirir. Yalnızca kelime listesine bakarak isim vermek, sık yapılan ve kolayca yanlış sonuç veren bir kısayoldur.
R ile LDA uygulaması
R ekosisteminde topicmodels paketi, LDA gibi klasik konu modelleme yöntemlerini uygulamak için kullanılır. Aşağıdaki örnek, önceden temizlenmiş metinlerin yorum_temiz sütununda bulunduğunu varsayar.
install.packages(c("tm", "topicmodels", "tidytext"))

library(tm)
library(topicmodels)
library(tidytext)
library(dplyr)

corpus <- VCorpus(VectorSource(df$yorum_temiz))
dtm <- DocumentTermMatrix(
  corpus,
  control = list(wordLengths = c(2, Inf))
)

# Çok seyrek terimleri filtrelemek gerekebilir
lda_model <- LDA(
  dtm, k = 6,
  method = "Gibbs",
  control = list(seed = 42, burnin = 1000,
                 iter = 2000, thin = 100)
)

terimler <- terms(lda_model, 10)
terimler
Uygulamadan önce boş belgeleri, çok seyrek terimleri ve çok yaygın kelimeleri kontrol edin. Gibbs örneklemesinde iterasyon, burn-in ve thinning ayarları veriye ve modelin yakınsama davranışına göre belirlenmelidir; varsayılan değerleri sorgusuz kullanmak yanıltıcı sonuçlar üretebilir.
Konu sayısı ve model kalitesi nasıl değerlendirilir?
Tek bir metrikle karar vermek yerine birden fazla kanıtı birlikte kullanın. Konu modellemede etiketli bir “doğru cevap” çoğu zaman bulunmadığı için değerlendirme; nicel ölçütleri, örnek belge incelemesini ve iş faydasını birleştirir.
| Yöntem | Ne anlatır? | Sınırlılık |
|---|---|---|
| Konu tutarlılığı | Aynı konuda üst sıralarda yer alan kelimelerin birlikte anlamlı olma eğilimi. | Tek başına insan tarafından yorumlanabilirliği garanti etmez. |
| Konu çeşitliliği | Konuların benzer kelime listelerini tekrar edip etmediği. | Çeşitlilik yüksek olsa da konular anlamsız olabilir. |
| Örnek belge incelemesi | Konuya yüksek ağırlık veren paylaşımların gerçekten aynı temayı taşıyıp taşımadığı. | Zaman alır; farklı analistlerin görüşleri değişebilir. |
| Zaman içinde kararlılık | Farklı örneklem veya dönemlerde benzer konuların ortaya çıkıp çıkmadığı. | Gerçek gündem değişimi de konu yapısını değiştirebilir. |
Pratikte birkaç farklı konu sayısı deneyin; her modelden en önemli kelimeleri ve o konuyla ilişkili örnek paylaşımları çıkarın. Konu isimlerini, kapsamını ve örtüşmesini not edin. Sonuçların karar verme sürecine katkı sağlayıp sağlamadığını da ayrıca değerlendirin — bir model istatistiksel olarak iyi, pratikte işe yaramaz olabilir.
LDA'nın sınırlılıkları ve alternatifler
- Kelime sırası: Standart LDA, kelime sırasını ve cümle yapısını doğrudan modellemez.
- Kısa metinler: Tek cümlelik paylaşımlarda kelime örtüşmesi az olduğundan konu çıkarımı zorlaşır. Benzer paylaşımları birleştirme veya kısa metne uygun yöntemler değerlendirilebilir.
- Önceden konu sayısı seçimi: K sayısı sonuçları belirgin biçimde etkiler ve veriden otomatik gelmez.
- Güncel dil ve ironi: Argo, ironi, emoji ve platforma özgü kullanım biçimleri yanlış yorumlanır.
- Konu adlandırma: Model, temaları kendiliğinden iş açısından anlamlı etiketlere dönüştürmez.
Alternatifler arasında NMF (Non-negative Matrix Factorization), metin gömmeleri (embeddings) üzerinde kümeleme, BERTopic gibi embedding tabanlı yaklaşımlar ve denetimli metin sınıflandırması bulunur. LDA sayım tabanlı ve yorumlanabilir bir başlangıçtır; ancak kısa sosyal medya metinlerinde embedding tabanlı yöntemler çoğu zaman daha anlamlı kümeler verir. Bu, kendi veri setiniz üzerinde test edilmesi gereken bir tercihtir — genel bir kural yoktur.
Üretim projesi için önerilen iş akışı
- Topla ve
Filtrele - Ön İşle
- Modeli
Kur - Konu Sayısını
Karşılaştır - Örnekleri
İncele - Raporla
- Kaynak, tarih, platform ve dil bilgilerini mümkünse koruyun.
- Ön işleme kurallarını versiyonlayın; aynı kurallarla tekrar üretilebilir sonuçlar alın.
- Konuları yalnızca kelime listesiyle değil, o konuyla ilişkili gerçek paylaşımlarla isimlendirin.
- Konu hacmini zaman, platform, marka veya kampanya kırılımlarında karşılaştırın.
- Bir konu hacmindeki artışı otomatik olarak kriz veya duygu değişimi saymayın; içerik örneklerini okuyun.
- Örneklem yanlılığı, botlar, spam ve platformların veri erişim kısıtlarını raporda açıkça belirtin.
Konu modelleme, keşif için güçlü bir başlangıçtır
Topic modeling, büyük sosyal medya veri kümelerinde tekrar eden temaları keşfetmek ve analistin incelemesi gereken alanları belirlemek için yararlı bir araçtır. LDA, belgeleri konu karışımları ve konuları kelime dağılımları olarak temsil ederek bu süreci olasılıksal bir çerçeveye taşır.
Ancak kaliteli sonuç yalnızca algoritmaya bağlı değildir. Türkçe metin ön işlemesi, konu sayısının seçimi, örnek paylaşımların incelenmesi, model kararlılığı ve iş hedefleri birlikte değerlendirilmelidir. Konu modellemenin en iyi kullanımı, otomatik çıktıyı nihai gerçek saymak değil; daha derin bir sosyal medya analizi için sistematik bir keşif katmanı olarak kullanmaktır.
What is topic modeling?
Topic modeling is a family of methods for discovering latent thematic structures in a collection of texts, using the words that tend to appear together. The model represents each text with one or more topics, and each topic as a probability distribution over words.
In social listening projects, topic modeling is used to group customer complaints, find what is being said about product features, surface campaign feedback, or notice emerging themes in the public conversation. Unlike traditional keyword search, you do not have to write the word list for every theme in advance.
Keyword search
You look for a known word or phrase. Fast and auditable for clearly defined topics — but it only finds what you were already looking for.
Topic modeling
Possible themes are discovered from word patterns. It can surface topics you did not expect; in return, the results have to be interpreted.
Where is it used in social media analysis?
- Customer experience: discovering recurring themes such as delivery, price, app performance and customer service.
- Brand reputation: examining which topics are discussed about the brand and how they shift over time.
- Campaign evaluation: understanding which messages, product features or experiences users focused on after a campaign.
- Competitor analysis: comparing the topic distributions of conversations about rival brands.
- Agenda and crisis monitoring: spotting sudden rises in topic volume early and routing them to expert review.
Topic modeling on its own is not sentiment analysis. A model finding a “delivery” theme tells you nothing about whether those conversations are positive or negative. The two complement each other: topic modeling gives you what is being discussed, sentiment analysis how.
How does LDA work?
Latent Dirichlet Allocation (LDA) is a probabilistic topic model that assumes documents are made up of a mixture of topics, and that each topic defines a probability distribution over words. The “document” here can be a single post, a comment, or a predefined chunk of text.
- Documents
- Word
Matrix - LDA
Model - Topic-Word
Distributions
Two core distributions
Topic → words
Shows which words represent a topic. For example “cargo”, “delivery”, “courier”, “order”.
Document → topics
Shows how strongly a post relates to each topic. A single post can carry probability across several topics.
LDA usually works on a document-term count matrix. How many times a word occurs in a document matters; word order is not modelled directly in the standard LDA representation. For idioms, irony and highly context-dependent expressions, LDA alone is therefore not enough.
Why does the number of topics matter?
The number of topics is chosen in advance. Too few topics merge distinct themes; too many split a single theme into fragments or produce noise. The number should be decided by weighing topic coherence, topic diversity, a reading of example documents, and the analytical purpose together.
Text preprocessing steps
The quality of a topic model usually depends on text preparation more than on the algorithm. Social media data contains emoji, URLs, user handles, hashtags, typos, abbreviations, repeated letters and platform-specific noise. Each cleaning step should be chosen for a purpose; over-cleaning destroys meaningful signal.
| Step | Purpose | Watch out for |
|---|---|---|
| Filtering records | Removing empty, duplicated or out-of-scope records. | A repeated post can be a genuine sign of reach; do not delete automatically. |
| Lowercasing | Reducing the fragmentation of word forms. | Think about context for proper nouns and abbreviations. |
| URLs and handles | Reducing unnecessary variable fragments. | A URL or account name may be meaningful for the research itself. |
| Tokenization | Splitting text into words or tokens. | Turkish is agglutinative; choose language-aware tools. |
| Stopword removal | Dropping very frequent, low-signal words. | Words like “not”, “none” and “very” can carry the meaning of a topic. |
| Stemming / lemmatization | Bringing inflections of a word together. | In Turkish, wrong stems produce meaningless topic words. |
| Compound phrases | Preserving meaningful word groups such as “customer service”. | Try bigram and trigram options. |
Notes specific to Turkish
Because Turkish is agglutinative, the forms “gel”, “geldi”, “gelmedi” and “gelecek” look different on the surface. Naive stem trimming does not always give the right answer. A Turkish-aware lemmatizer or a tool such as Zemberek is worth evaluating, but the output must be checked against real examples.
Removing negation words indiscriminately is also risky: the difference between “the product is good” and “the product is not good” disappears. Even though topic modeling does not classify sentiment, such words directly shape how a theme is interpreted.
An LDA example in Python
The example below shows a basic LDA workflow over a CSV file with a column named yorum (comment). The code is simplified for teaching; a production setup needs Turkish tokenization, a domain-specific stopword list, data quality checks and model evaluation.
1. Installing the packages
pip install pandas scikit-learn2. Preparing the text and the document-term matrix
import re
import pandas as pd
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.decomposition import LatentDirichletAllocation

df = pd.read_csv("sosyal_medya_yorumlari.csv")
df = df.dropna(subset=["yorum"]).copy()
df["yorum"] = df["yorum"].astype(str)

def temizle(metin):
    metin = metin.lower()
    metin = re.sub(r"https?://\S+|www\.\S+", " ", metin)
    metin = re.sub(r"@\w+", " ", metin)
    metin = re.sub(r"[^a-zA-ZçğıöşüÇĞİÖŞÜ\s]", " ", metin)
    metin = re.sub(r"\s+", " ", metin).strip()
    return metin

df["temiz_yorum"] = df["yorum"].map(temizle)

stop_words_tr = [
    "ve", "veya", "ama", "ile", "bir",
    "bu", "şu", "çok", "daha", "için",
    "gibi", "mi", "mı", "de", "da"
]

vectorizer = CountVectorizer(
    stop_words=stop_words_tr,
    min_df=5,
    max_df=0.85,
    ngram_range=(1, 2)
)
X = vectorizer.fit_transform(df["temiz_yorum"])
min_df=5 keeps terms appearing in at least five documents; max_df=0.85 drops terms seen in more than 85% of them. On a small dataset these thresholds are too aggressive. The stopword list shown is only an example; a real Turkish project needs it extended with domain-specific words.
3. Training the LDA model
n_konu = 6

lda = LatentDirichletAllocation(
    n_components=n_konu,
    max_iter=20,
    learning_method="batch",
    random_state=42
)
doc_topic = lda.fit_transform(X)
kelimeler = vectorizer.get_feature_names_out()

def konu_kelimeleri(model, kelimeler, n=10):
    for i, dagilim in enumerate(model.components_):
        en_iyi = dagilim.argsort()[-n:][::-1]
        terimler = [kelimeler[j] for j in en_iyi]
        print(f"Topic {i + 1}: " + ", ".join(terimler))

konu_kelimeleri(lda, kelimeler, n=10)

df["baskin_konu"] = doc_topic.argmax(axis=1) + 1
df["konu_guveni"] = doc_topic.max(axis=1)
The values in components_ are learned parameters representing word weights within a topic; they should not be read directly as calibrated probabilities. doc_topic gives the topic mixture of each document. The dominant-topic label is a useful summary, but it hides the fact that a document can carry several topics — which is why we keep the konu_guveni (confidence) column.
4. Interpreting the topics
If topic 1 shows words like “cargo, delivery, order, courier” and topic 2 shows “app, login, error, screen”, these can be read as delivery and app experience themes. But the algorithm does not supply topic names. The analyst names them by reading the words together with the real posts assigned to that topic with high probability. Naming a topic from the word list alone is a common shortcut that easily goes wrong.
An LDA implementation in R
In the R ecosystem, the topicmodels package is used for classic topic modeling methods such as LDA. The example below assumes the pre-cleaned texts sit in a yorum_temiz column.
install.packages(c("tm", "topicmodels", "tidytext"))

library(tm)
library(topicmodels)
library(tidytext)
library(dplyr)

corpus <- VCorpus(VectorSource(df$yorum_temiz))
dtm <- DocumentTermMatrix(
  corpus,
  control = list(wordLengths = c(2, Inf))
)

# Very sparse terms may need filtering
lda_model <- LDA(
  dtm, k = 6,
  method = "Gibbs",
  control = list(seed = 42, burnin = 1000,
                 iter = 2000, thin = 100)
)

terimler <- terms(lda_model, 10)
terimler
Before running it, check for empty documents, very sparse terms and very frequent words. For Gibbs sampling, the iteration, burn-in and thinning settings should be chosen from the data and the model's convergence behaviour; taking the defaults unquestioned can produce misleading results.
How do you evaluate topic count and model quality?
Rather than deciding on a single metric, use several pieces of evidence together. Because there is usually no labelled “right answer” in topic modeling, evaluation combines quantitative measures, example document review and business usefulness.
| Method | What it tells you | Limitation |
|---|---|---|
| Topic coherence | Whether the top-ranked words in a topic tend to make sense together. | On its own it does not guarantee human interpretability. |
| Topic diversity | Whether topics repeat similar word lists. | Diversity can be high while the topics remain meaningless. |
| Example review | Whether posts weighted heavily towards a topic really share that theme. | Takes time; different analysts may disagree. |
| Stability over time | Whether similar topics emerge across samples or periods. | A genuine shift in the agenda also changes topic structure. |
In practice, try several topic counts; extract the leading words and the example posts associated with each topic in every model. Note the topic names, their scope and their overlap. Then evaluate separately whether the results contribute to the decision at hand — a model can be statistically good and practically useless.
The limits of LDA, and the alternatives
- Word order: standard LDA does not model word order or sentence structure directly.
- Short texts: in one-sentence posts there is little word overlap, which makes topic inference harder. Aggregating similar posts, or using methods designed for short text, is worth considering.
- Choosing K in advance: the topic count markedly shapes the results and does not come from the data automatically.
- Current language and irony: slang, irony, emoji and platform-specific usage get misread.
- Naming topics: the model does not turn themes into business-meaningful labels by itself.
Alternatives include NMF (Non-negative Matrix Factorization), clustering over text embeddings, embedding-based approaches such as BERTopic, and supervised text classification. LDA is a count-based, interpretable starting point; but on short social media texts, embedding-based methods often give more meaningful clusters. This is a choice to test on your own dataset — there is no general rule.
A suggested workflow for a production project
- Collect &
Filter - Preprocess
- Build the
Model - Compare
Topic Counts - Review
Examples - Report
- Keep source, date, platform and language information wherever you can.
- Version your preprocessing rules so the same rules reproduce the same results.
- Name topics with the real posts associated with them, not with the word list alone.
- Compare topic volume across time, platform, brand or campaign breakdowns.
- Do not treat a rise in topic volume automatically as a crisis or a sentiment shift; read the content samples.
- State sampling bias, bots, spam and platform data-access limits explicitly in the report.
Topic modeling is a strong starting point for discovery
Topic modeling is a useful tool for finding recurring themes in large social media datasets and for identifying the areas an analyst should examine. LDA brings that process into a probabilistic frame by representing documents as topic mixtures and topics as word distributions.
But quality does not depend on the algorithm alone. Turkish text preprocessing, the choice of topic count, the review of example posts, model stability and business goals all have to be weighed together. The best use of topic modeling is not to take the automatic output as final truth, but to treat it as a systematic discovery layer for deeper social media analysis.