Çoklu Doğrusal Regresyonda Varsayım Testleri
Hangi varsayım katsayıyı yanlı yapar, hangisi sadece p-değerini bozar? Artık grafiklerinden Breusch–Pagan ve Durbin–Watson'a, sağlam standart hatalardan etkili gözlemlere kadar pratik bir tanı rehberi.
- İstatistik
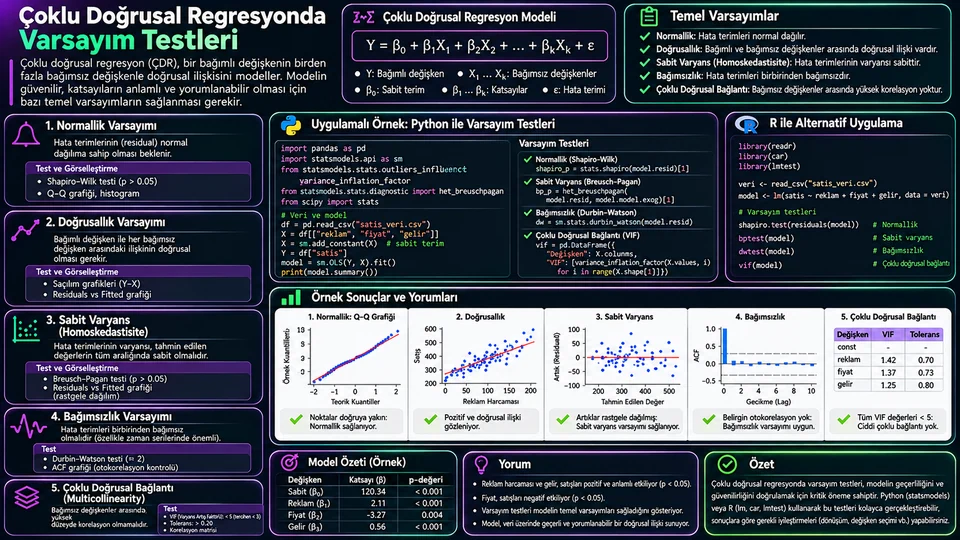
Varsayımlar neden önemli?
Çoklu doğrusal regresyon, bir sonuç değişkenini birden fazla açıklayıcı değişkenle ilişkilendirir. Model kurulduğunda Python veya R size her zaman bir katsayı tablosu verir — model uygun olsa da olmasa da. Varsayım testleri, o tablodaki sayılara ne kadar güvenebileceğinizi anlamaya yarar.
Burada sık atlanan bir ayrım var: bazı varsayımlar katsayı tahmininin kendisini, bazıları ise yalnızca standart hataları, p-değerlerini ve güven aralıklarını etkiler. İkisini birbirine karıştırmak, gereksiz paniğe ya da yanlış rahatlamaya yol açar.
Bir başka uyarı: tanı testleri "model doğru/yanlış" mührü değildir. Büyük örneklemlerde çok küçük sapmalar bile testleri anlamlı kılar; küçük örneklemlerde ise ciddi sorunları yakalamak zordur. Testi grafikle, grafiği alan bilgisiyle birlikte okuyun.
Varsayımlara hızlı bakış
| Varsayım | Anlamı | İhlal edilirse ne olur? |
|---|---|---|
| Doğrusallık | Koşullu ortalama, katsayılarla tanımlanan biçimde modellenmiş | Sistematik artık örüntüsü, yanlı tahminler |
| Dışsallık | Hatalar açıklayıcı değişkenlerle sistematik ilişkili değil | Katsayılar yanlı ve tutarsız |
| Sabit varyans | Hata yayılımı tahmin düzeyleri boyunca benzer | Standart hatalar ve testler yanıltıcı |
| Bağımsız hatalar | Bir gözlemin hatası diğerininkini taşımıyor | Belirsizlik olduğundan küçük hesaplanır |
| Çoklu bağlantı yok | Tam doğrusal bağımlı açıklayıcı yok | Katsayılar ayrı ayrı tanımlanamaz veya kararsız |
| Artıkların normalliği | Koşullu hata dağılımı yaklaşık normal | Küçük örneklemde çıkarım etkilenir |
Listede olmayan bir şeye dikkat edin: bağımsız değişkenlerin normal dağılması gerekmez. Bu, en yaygın yanlış bilgilerden biridir. Açıklayıcı değişken kategorik, çarpık, ikili veya tamamen düzensiz olabilir — OLS bunu sorun etmez.
Örnek modeli kurmak
Aşağıdaki örnek sentetik bir satış verisi üretip OLS modeli kurar. Gerçek projede değişkenleri, eksik değer işlemini ve kategori kodlamasını kendi verinize göre ayarlayın.
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 250

reklam = rng.normal(50, 12, n)
fiyat = rng.normal(20, 4, n)
magaza = rng.normal(100, 18, n)
hata = rng.normal(0, 12, n)

df = pd.DataFrame({
    "satis": 30 + 1.8*reklam - 2.1*fiyat + 0.7*magaza + hata,
    "reklam": reklam,
    "fiyat": fiyat,
    "magaza": magaza,
})

model = smf.ols("satis ~ reklam + fiyat + magaza", data=df).fit()
print(model.summary())
Formula arayüzü sabit terimi otomatik ekler. Katsayılar, diğer değişkenler sabit tutulduğunda ilgili değişkendeki bir birimlik artışın koşullu ortalama sonuçla ilişkisini verir — "sabit tutulduğunda" ifadesi burada kritiktir ve çoklu bağlantı varken anlamını kaybetmeye başlar.
1. Doğrusallık ve model biçimi
Regresyondaki "doğrusallık", sonucun her ham değişkenle düz çizgi ilişkisi içinde olması demek değildir. Model katsayılar açısından doğrusal olmalıdır; değişkenin karesi, logaritması veya iki değişkenin etkileşimi modele girebilir ve model hâlâ doğrusal regresyondur.
Kontrol yöntemi artık–tahmin grafiğidir. Yatay bir bulut bekleriz. Eğri bir örüntü görüyorsanız model biçimi eksiktir; huni şeklindeki bir yayılım ise bir sonraki bölümün konusudur.
import matplotlib.pyplot as plt
import seaborn as sns

sns.residplot(
    x=model.fittedvalues, y=model.resid,
    lowess=True, line_kws={"color": "red"}
)
plt.axhline(0, color="gray", linestyle="--")
plt.xlabel("Tahmin edilen değer")
plt.ylabel("Artık")
plt.show()
Kırmızı lowess çizgisi sıfır etrafında düz gitmiyorsa, model sistematik bir şeyi kaçırıyor demektir. Çözüm olarak dönüşüm, polinom terimi veya etkileşim eklenebilir — ama terimi yalnızca grafiği düzleştirmek için eklemeyin. Her ek terimin bir gerekçesi olmalı; aksi hâlde veriye uydurma (overfitting) yapmış olursunuz.
2. Sabit varyans (homoskedastisite)
Homoskedastisite, artıkların yayılımının tahmin düzeyleri boyunca yaklaşık sabit kalmasıdır. Satış, gelir, harcama gibi değişkenlerde bu varsayım sık ihlal edilir: büyük değerlerde sapma da büyür, grafik huni şeklini alır.
Breusch–Pagan testi, artık varyansının açıklayıcı değişkenlerle ilişkili olmadığı sıfır hipotezini sınar. Küçük p-değeri, değişen varyans lehine kanıttır.
from statsmodels.stats.diagnostic import het_breuschpagan

lm, lm_p, f_stat, f_p = het_breuschpagan(
    model.resid, model.model.exog
)
print({"LM p": round(lm_p, 4), "F p": round(f_p, 4)})
Burada önemli bir nokta var: heteroskedastisite katsayıları yanlı yapmaz. Tahminler hâlâ doğru merkez etrafındadır. Bozulan şey standart hatalardır — yani p-değerleriniz ve güven aralıklarınız güvenilmez hâle gelir.
Bu yüzden çözüm de çoğu zaman modeli değiştirmek değildir. En pratik yol sağlam (robust) standart hatalar kullanmaktır:
# HC3, küçük-orta örneklemde yaygın tercih
robust = model.get_robustcov_results(cov_type="HC3")
print(robust.summary())
Katsayılar aynı kalır, standart hatalar düzeltilir. Alternatifler: bağımlı değişkenin logaritmasını almak (çarpımsal bir ilişki varsa anlamlı olabilir) veya ağırlıklı en küçük kareler kullanmak.
3. Hata bağımsızlığı
Gözlemler zaman sırasına göre diziliyse, ardışık hatalar birbirini taşıyabilir. Bu durumda model belirsizliği olduğundan küçük hesaplar: p-değerleriniz olması gerekenden küçük çıkar ve aslında anlamsız olan bir ilişkiyi anlamlı sanırsınız.
Durbin–Watson istatistiği birinci dereceden seri korelasyon için yaygın bir tanıdır. Değer 2'ye yakınsa sinyal zayıftır; 0'a yaklaşması pozitif, 4'e yaklaşması negatif otokorelasyonla uyumludur.
from statsmodels.stats.stattools import durbin_watson

print("DW:", round(durbin_watson(model.resid), 3))

# Artıkları gözlem sırasına göre çizmek, testten daha açıklayıcıdır
plt.plot(model.resid, marker=".", linestyle="-", alpha=0.6)
plt.axhline(0, color="gray", linestyle="--")
plt.xlabel("Gözlem sırası"); plt.ylabel("Artık")
plt.show()4. Artıkların normalliği
Bu tanı artıklara uygulanır, açıklayıcı değişkenlere değil. Q–Q grafiğinde noktalar referans çizgisini izliyorsa normale yakın bir dağılım var demektir; kuyruklardaki sapmalar aykırı gözlemlere işaret eder.
import statsmodels.api as sm
from statsmodels.stats.stattools import jarque_bera

sm.qqplot(model.resid, line="45", fit=True)
plt.title("Artıkların Q–Q grafiği")
plt.show()

# statsmodels sürümü 4 değer döndürür
jb, jb_p, skew, kurt = jarque_bera(model.resid)
print({"JB p": round(jb_p, 4),
       "çarpıklık": round(skew, 3),
"basıklık": round(kurt, 3)})scipy.stats.jarque_bera yalnızca iki değer (istatistik ve p-değeri) döndürür; dört değişkene açmaya çalışırsanız hata alırsınız. Çarpıklık ve basıklığı da birlikte isteyen sürüm statsmodels.stats.stattools.jarque_bera'dır.Yorumlarken iki tuzaktan kaçının. Büyük p-değeri normalliği kanıtlamaz, yalnızca aksine kanıt bulunamadığını söyler. Ve büyük örneklemlerde pratik olarak önemsiz sapmalar bile anlamlı çıkar — 5.000 gözlemde Jarque–Bera neredeyse her zaman reddeder. Böyle durumlarda testten çok Q–Q grafiğinin şekline bakın.
5. Çoklu doğrusal bağlantı
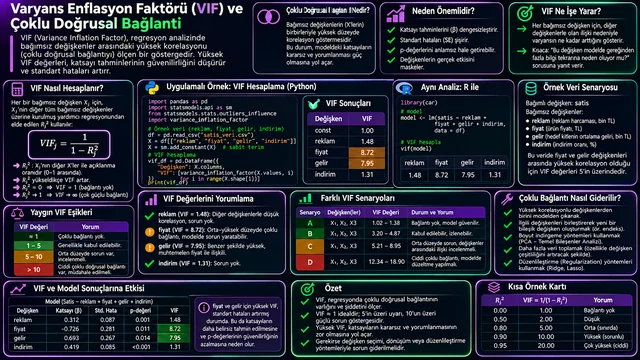
Açıklayıcı değişkenler birbirinin doğrusal bileşimi gibi davrandığında katsayı standart hataları büyür ve küçük veri değişimlerinde katsayılar oynar. Varyans şişirme faktörü (VIF) bunu değişken başına tek sayıyla özetler: VIF = 1/(1 − R²j).
from statsmodels.stats.outliers_influence import variance_inflation_factor

X = model.model.exog
adlar = model.model.exog_names

vif = pd.DataFrame({
    "degisken": adlar,
    "VIF": [variance_inflation_factor(X, i)
            for i in range(X.shape[1])],
})
print(vif[vif["degisken"] != "Intercept"].round(2))
Sabit terimin VIF'ini yorumlamayın. 5 veya 10 gibi eşikler inceleme sinyalidir, mekanik karar kuralı değil. Yüksek VIF gördüğünüzde önce yapısal bir hata arayın: aynı değişken iki kez mi eklenmiş, bir toplam ve bileşenleri birlikte mi duruyor?
6. Etkili gözlemler
Varsayım listelerinde genellikle yer almayan ama pratikte en sık soruna yol açan konu budur. Tek bir uç gözlem, katsayıları tek başına sürükleyebilir. Cook mesafesi, bir gözlemin çıkarılmasının tahminleri ne kadar değiştireceğini ölçer.
etki = model.get_influence()
cooks = etki.cooks_distance[0]

print("En etkili 5 gözlem:")
print(pd.Series(cooks).nlargest(5).round(4))Tanıları bir arada çalıştırmak
- Veriyi
Doğrula - Grafiklere
Bak - Testleri
Çalıştır - Etkili Gözlem
İncele - Sınırlamaları
Raporla
- Önce veriyi doğrulayın. Hatalı ölçüm, yanlış kodlama, beklenmeyen eksik değer var mı? Tanıların yarısı burada çözülür.
- Grafiklere bakın. Artık–tahmin ve Q–Q grafikleri, sayısal testlerden daha fazla bilgi taşır. Örüntüyü adlandırın: eğrilik mi, huni mi, kümelenme mi?
- Testleri çalıştırın ama hepsini birden uygulamanın yanlış alarm olasılığını artırdığını unutmayın. Modelinizin sorusuna uygun tanıyı seçin.
- Etkili gözlemleri inceleyin. Cook mesafesi ve kaldıraç değerleri, tek bir satırın sonucu sürükleyip sürüklemediğini gösterir.
- Sınırlamaları raporlayın. Hangi varsayım, hangi bulguyla sorunlu; ne yaptınız, ne yapmadınız?
Kontrol listesi
- Model sorusu ve değişken seçimi gerekçelendirildi.
- Artık–tahmin grafiği incelendi, örüntü adlandırıldı.
- Q–Q grafiği çizildi; normallik testi örneklem büyüklüğü dikkate alınarak yorumlandı.
- Breusch–Pagan çalıştırıldı; gerekiyorsa sağlam standart hata kullanıldı.
- Zaman sırası varsa artıklar sıraya göre çizildi, DW hesaplandı.
- VIF hesaplandı, sabit terim dışlandı.
- Cook mesafesi ile etkili gözlemler arandı.
- Yapılan düzeltmelerin katsayılara etkisi öncesi/sonrası raporlandı.
Sonuç
Regresyon varsayımları, geçilmesi gereken bir sınav listesi değildir. Her tanı size farklı bir soru sorar: katsayılar yanlı mı, standart hatalar güvenilir mi, sonuç tek bir gözleme mi dayanıyor?
Pratik yaklaşım şu: önce grafiklere bakın, testleri grafikleri yorumlamak için kullanın, bulduğunuz sorunu gerekçeli bir düzeltmeyle karşılayın ve kalan sınırlamaları açıkça yazın. "Tüm varsayımlar sağlandı" demek nadiren dürüst bir cümledir; "şu varsayımda şu sapma var, etkisi şu kadar" demek her zaman daha güçlüdür.
Why do the assumptions matter?
Multiple linear regression relates an outcome to several explanatory variables. Once the model is fitted, Python or R will always hand you a coefficient table — whether or not the model is appropriate. Assumption testing is how you work out how much to trust the numbers in that table.
There is a distinction that often gets skipped: some assumptions affect the coefficient estimates themselves, others only affect standard errors, p-values and confidence intervals. Confusing the two leads either to needless panic or to false comfort.
Another caution: diagnostic tests are not a stamp of "model correct / model wrong". In large samples even tiny deviations make tests significant; in small samples serious problems are hard to detect. Read the test alongside the plot, and the plot alongside domain knowledge.
The assumptions at a glance
| Assumption | What it means | What happens if violated |
|---|---|---|
| Linearity | The conditional mean is modelled in the form the coefficients describe | Systematic residual pattern, biased estimates |
| Exogeneity | Errors are not systematically related to the regressors | Coefficients are biased and inconsistent |
| Constant variance | Error spread is similar across fitted levels | Standard errors and tests mislead |
| Independent errors | One observation's error does not carry into another's | Uncertainty is computed too small |
| No perfect collinearity | No regressor is an exact linear combination of others | Coefficients undefined or unstable |
| Normal residuals | The conditional error distribution is roughly normal | Classical inference suffers in small samples |
Note what is not on the list: explanatory variables do not need to be normally distributed. This is one of the most widespread misconceptions. A regressor can be categorical, skewed, binary or entirely irregular — OLS does not mind.
Setting up the example model
The example below generates synthetic sales data and fits an OLS model. In a real project, adapt the variables, missing-value handling and category encoding to your own data.
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 250

adspend = rng.normal(50, 12, n)
price = rng.normal(20, 4, n)
store = rng.normal(100, 18, n)
error = rng.normal(0, 12, n)

df = pd.DataFrame({
    "sales": 30 + 1.8*adspend - 2.1*price + 0.7*store + error,
    "adspend": adspend,
    "price": price,
    "store": store,
})

model = smf.ols("sales ~ adspend + price + store", data=df).fit()
print(model.summary())
The formula interface adds the intercept automatically. Coefficients give the association between a one-unit increase in the variable and the conditional mean outcome, holding the others constant — and "holding constant" is exactly the phrase that starts losing meaning when collinearity is present.
1. Linearity and model form
"Linearity" in regression does not mean the outcome must follow a straight line against every raw variable. The model must be linear in the coefficients; a squared term, a logarithm or an interaction can all enter, and it is still linear regression.
The check is the residuals-versus-fitted plot. We want a flat cloud. A curved pattern means the model form is incomplete; a funnel-shaped spread is the subject of the next section.
import matplotlib.pyplot as plt
import seaborn as sns

sns.residplot(
    x=model.fittedvalues, y=model.resid,
    lowess=True, line_kws={"color": "red"}
)
plt.axhline(0, color="gray", linestyle="--")
plt.xlabel("Fitted value")
plt.ylabel("Residual")
plt.show()
If the red lowess line does not run flat around zero, the model is missing something systematic. A transformation, a polynomial term or an interaction can help — but do not add a term merely to flatten the plot. Every extra term needs a justification; otherwise you are fitting the noise.
2. Constant variance (homoskedasticity)
Homoskedasticity means the spread of residuals stays roughly constant across fitted levels. With variables such as sales, income or spending this assumption is often violated: deviation grows with the magnitude, and the plot takes on a funnel shape.
The Breusch–Pagan test examines the null hypothesis that residual variance is not related to the explanatory variables. A small p-value is evidence for heteroskedasticity.
from statsmodels.stats.diagnostic import het_breuschpagan

lm, lm_p, f_stat, f_p = het_breuschpagan(
    model.resid, model.model.exog
)
print({"LM p": round(lm_p, 4), "F p": round(f_p, 4)})
An important point here: heteroskedasticity does not bias the coefficients. The estimates are still centred correctly. What breaks is the standard errors — which makes your p-values and confidence intervals unreliable.
So the fix usually is not to change the model. The most practical route is robust standard errors:
# HC3 is a common choice for small to medium samples
robust = model.get_robustcov_results(cov_type="HC3")
print(robust.summary())
The coefficients stay the same; the standard errors are corrected. Alternatives: taking the logarithm of the dependent variable (sensible if the relationship is multiplicative), or weighted least squares.
3. Independence of errors
If observations are ordered in time, consecutive errors can carry into one another. The model then computes uncertainty too small: your p-values come out lower than they should, and you take a relationship to be significant when it is not.
The Durbin–Watson statistic is a common diagnostic for first-order serial correlation. A value near 2 means a weak signal; approaching 0 is consistent with positive, approaching 4 with negative autocorrelation.
from statsmodels.stats.stattools import durbin_watson

print("DW:", round(durbin_watson(model.resid), 3))

# Plotting residuals in observation order says more than the test
plt.plot(model.resid, marker=".", linestyle="-", alpha=0.6)
plt.axhline(0, color="gray", linestyle="--")
plt.xlabel("Observation order"); plt.ylabel("Residual")
plt.show()4. Normality of residuals
This diagnostic applies to the residuals, not to the explanatory variables. If the points on a Q–Q plot follow the reference line, the distribution is close to normal; deviations in the tails point to outlying observations.
import statsmodels.api as sm
from statsmodels.stats.stattools import jarque_bera

sm.qqplot(model.resid, line="45", fit=True)
plt.title("Q–Q plot of residuals")
plt.show()

# The statsmodels version returns 4 values
jb, jb_p, skew, kurt = jarque_bera(model.resid)
print({"JB p": round(jb_p, 4),
       "skew": round(skew, 3),
"kurtosis": round(kurt, 3)})scipy.stats.jarque_bera returns only two values (the statistic and the p-value); unpacking it into four names raises an error. The version that also gives skewness and kurtosis is statsmodels.stats.stattools.jarque_bera.Avoid two traps when interpreting. A large p-value does not prove normality; it only says no evidence against it was found. And in large samples even practically irrelevant deviations come out significant — with 5,000 observations Jarque–Bera rejects almost every time. In that situation, look at the shape of the Q–Q plot rather than the test.
5. Multicollinearity
When explanatory variables behave like linear combinations of each other, coefficient standard errors grow and the coefficients move with small changes in the data. The variance inflation factor (VIF) summarises this per variable with one number: VIF = 1/(1 − R²j).
from statsmodels.stats.outliers_influence import variance_inflation_factor

X = model.model.exog
names = model.model.exog_names

vif = pd.DataFrame({
    "variable": names,
    "VIF": [variance_inflation_factor(X, i)
            for i in range(X.shape[1])],
})
print(vif[vif["variable"] != "Intercept"].round(2))
Do not interpret the intercept's VIF. Thresholds such as 5 or 10 are signals to investigate, not mechanical decision rules. When you see a high VIF, look for a structural error first: was the same variable added twice, or is a total sitting alongside its components?
6. Influential observations
This rarely appears on assumption lists yet causes trouble most often in practice. A single extreme observation can drag the coefficients on its own. Cook's distance measures how much removing an observation would change the fitted values.
influence = model.get_influence()
cooks = influence.cooks_distance[0]

print("Five most influential observations:")
print(pd.Series(cooks).nlargest(5).round(4))Running the diagnostics together
- Verify the
Data - Look at
the Plots - Run the
Tests - Examine
Influence - Report the
Limitations
- Verify the data first. Faulty measurement, wrong coding, unexpected missing values? Half of all diagnostics resolve here.
- Look at the plots. Residuals-versus-fitted and Q–Q carry more information than numerical tests. Name the pattern: curvature, funnel, clustering?
- Run the tests, but remember that applying all of them at once raises the chance of a false alarm. Choose the diagnostic that matches your model's question.
- Examine influential points. Cook's distance and leverage show whether a single row is driving the result.
- Report the limitations. Which assumption, on what evidence; what you did and what you did not.
Checklist
- The model question and variable selection are justified.
- The residuals-versus-fitted plot was examined and the pattern named.
- A Q–Q plot was drawn; the normality test was read with sample size in mind.
- Breusch–Pagan was run; robust standard errors were used where needed.
- With a time ordering, residuals were plotted in sequence and DW computed.
- VIF was computed with the intercept excluded.
- Influential observations were sought with Cook's distance.
- The before/after effect of any correction on the coefficients was reported.
Conclusion
Regression assumptions are not a checklist of exams to pass. Each diagnostic asks you a different question: are the coefficients biased, are the standard errors trustworthy, does the result rest on a single observation?
The practical approach: look at the plots first, use the tests to interpret the plots, meet any problem you find with a justified correction, and state the remaining limitations plainly. "All assumptions were satisfied" is rarely an honest sentence; "this assumption deviates in this way, and the effect is this large" is always stronger.