Karar Ağacı / CART
Karar Ağaçları, hem sınıflandırma hem de regresyon problemleri için kullanılan, ağaç benzeri bir yapıya sahip makine öğrenimi algoritmalarıdır. Verileri özelliklerine göre dallara ayırarak bir dizi karar kuralı oluşturur ve bu kurallar sayesinde hedef değişkenin değerini tahmin eder. Yorumlanabilirliği yüksek ve uygulaması nispeten kolay bir modeldir.
- Makine Öğrenmesi
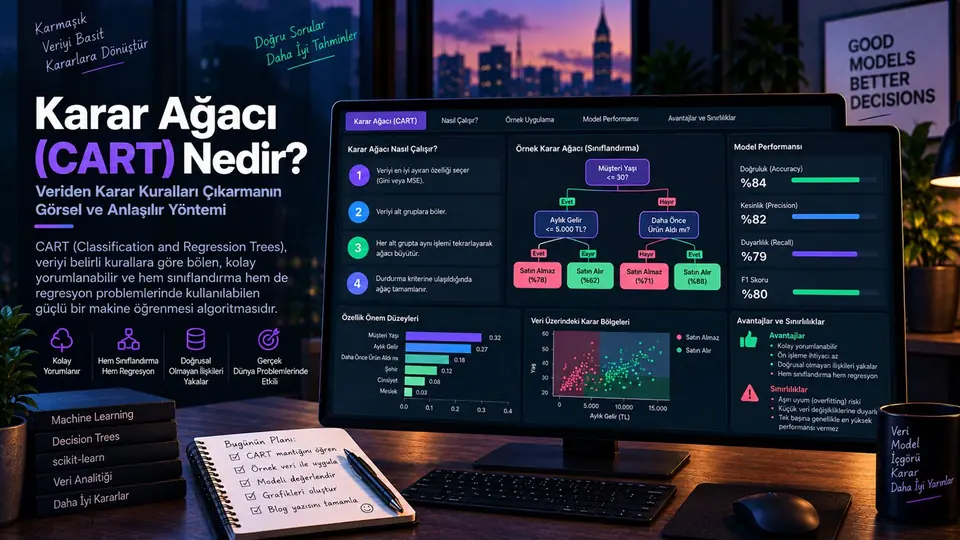
Karar ağacı, veriyi bir dizi koşullu kurala göre alt gruplara bölerek tahmin yapan bir makine öğrenmesi modelidir. Ağacın her düğümünde bir değişkene ilişkin soru sorulur, dallar bu sorunun olası yanıtlarını temsil eder ve yapraklarda tahmin edilen sınıf ya da sayısal değer bulunur. Bu yazının konusu olan CART (Classification and Regression Trees) algoritması; her düğümü ikiye bölen ve hem sınıflandırma hem de regresyon problemlerinde çalışabilen bir karar ağacı yöntemidir.
Karar ağaçları makine öğrenmesinin dışında, karar analizi alanında da kullanılır. Orada seçenekleri, şans olaylarını ve olası sonuçları görselleştiren bir karar destek diyagramı olarak ele alınırlar; yani veriden öğrenilen bir model değil, bir düşünme aracıdır. İki kullanım aynı “ağaç” görselini paylaşır; bu yazıda ise veriden otomatik olarak öğrenilen istatistiksel modeli inceliyoruz.
Karar ağacının avantajları:
- Anlaşılması ve yorumlanması basittir: bir tahminin neden yapıldığı, kökten yaprağa giden kural zinciri okunarak açıklanabilir.
- Hem sayısal hem kategorik değişkenlerle çalışır; ölçekleme veya normalizasyon gerektirmez.
- Değişkenler arasındaki doğrusal olmayan ilişkileri ve etkileşimleri kendiliğinden yakalayabilir.
- Hangi değişkenin bölünmelerde ne kadar işe yaradığını gösteren değişken önemi (feature importance) çıktısı üretir.
- Rastgele orman ve gradyan artırma gibi daha güçlü topluluk yöntemlerinin temel yapı taşıdır.
Karar ağacının dezavantajları:
- Kararsızdırlar, yani verilerdeki küçük bir değişikliğin, en iyi durumdaki karar ağacının yapısında büyük bir değişikliğe yol açabileceği anlamına gelmektedir.
- Genellikle hatalıdırlar. Diğer birçok tahmin algoritmaları benzer verilerle daha iyi performans gösterir. Bu, tek bir karar ağacını rastgele orman ile değiştirerek düzeltilebilir, ancak rastgele ormanın tek bir karar ağacı kadar yorumlanması kolay değildir.
- Farklı sayıda seviyeye sahip kategorik değişkenler içeren veriler için, karar ağaçlarındaki bilgi kazanımı, daha fazla seviyeye sahip öznitelikler lehine önyargılıdır.
- Hesaplamalar çok karmaşık hale gelebilir, özellikle de birçok değer belirsizse veya birçok sonuç ile bağlantılıysa.
1. Sınıflandırma Metrikleri (Homojenliği Ölçmek)
Sınıflandırma ağaçlarında (Classification Trees), bir düğümdeki verilerin ne kadar "karışık" (saf değil) olduğunu ölçmek için iki ana metrik kullanılır:
A. Gini Kirliliği (Gini Impurity)
Gini kirliliği, rastgele seçilen bir öğenin yanlış sınıflandırılma olasılığını ölçer. Amacımız, Gini kirliliğini en aza indiren bölünmeyi bulmaktır.
Bir düğümdeki j sınıfının oranı pj olmak üzere, Gini Kirliliği IG şu şekilde hesaplanır:
- C: Toplam sınıf sayısı.
- Amaç: Bir düğüm bölündükten sonra, alt düğümlerin değerlerinin ağırlıklı ortalamasını minimize etmektir. sıfıra (0) ne kadar yakınsa, düğüm o kadar saftır (homojendir).
B. Entropi ve Bilgi Kazancı (Entropy and Information Gain)
Entropi, bir sistemdeki rastgelelik veya düzensizlik (bilgisizlik) ölçüsüdür. Entropi ne kadar yüksekse, verideki karışıklık o kadar fazladır.
Bilgi Kazancı (Information Gain - IG), bir bölünme sonucunda Entropi'deki azalmayı ölçer. Algoritma, en yüksek Bilgi Kazancını (yani Entropi'deki en büyük azalmayı) sağlayan özelliği ve bölünme noktasını seçer.
- : Bölünme öncesi düğümün Entropisi.
- : Bölünme sonrası alt düğümlerin ağırlıklı Entropisi.
2. Regresyon Metrikleri
Regresyon ağaçlarında (Regression Trees), amaç bir sınıf etiketi tahmin etmek yerine sürekli bir değer tahmin etmek olduğundan, homojenlik (saflık), tahmini değerin ne kadar iyi temsil edildiği ile ölçülür.
Temel olarak kullanılan metrik Ortalama Kare Hata (Mean Squared Error - MSE) veya varyans azalmasıdır. Algoritma, alt düğümlerdeki varyansı en aza indirecek bölünmeyi seçer.
Bir düğümün MSE'si, o düğümdeki örneklerin ortalama değere olan sapmalarının karesiyle hesaplanır. Bölünme, MSE'yi en çok azaltan özellik ve eşik değerine göre yapılır.
3. Aşırı Uyum ve Budama (Overfitting and Pruning)
Karar Ağaçları'nın en büyük akademik zorluğu, eğitim verisine aşırı uyum (overfitting) eğilimidir. Ağaç, her yaprak düğümünde yalnızca tek bir örneği bırakacak kadar derine inerse, eğitim verisini mükemmel ezberler ancak yeni, görünmeyen verilerde kötü performans gösterir.
Bu durumu önlemek için Budama (Pruning) teknikleri kullanılır:
- Ön Budama (Pre-pruning): Ağacın büyümesini, bir düğümdeki örnek sayısı belirli bir eşiğin altına düştüğünde veya bölünmeden sonraki bilgi kazancı çok düşük olduğunda durdurur.
- Art Budama (Post-pruning): Tamamen büyümüş bir ağacı oluşturduktan sonra, genelleme yeteneğini artıran düğümleri keser. Buna, Maliyet Karmaşıklığı Budaması (Cost-Complexity Pruning) örnek verilebilir.
Bu matematiksel ve istatistiksel temeller, Karar Ağaçları'nın neden güçlü bir temel algoritma olduğunu gösterir.
A decision tree is a machine learning model that makes predictions by splitting the data into subgroups according to a series of conditional rules. Each internal node asks a question about a feature, the branches represent the possible answers, and the leaves hold the predicted class or numeric value. CART (Classification and Regression Trees), the subject of this post, is a decision tree method that splits every node in two and works for both classification and regression problems.
Decision trees are also used outside machine learning, in decision analysis, where they serve as a decision-support diagram that visualizes options, chance events and possible outcomes — a way of thinking rather than a model learned from data. Both uses share the same “tree” picture, but this post looks at the statistical model that is learned automatically from data.
Advantages of decision trees:
- Simple to understand and interpret: a prediction can be explained by reading the chain of rules that runs from the root to the leaf.
- Works with both numeric and categorical variables, and requires no scaling or normalization.
- Captures non-linear relationships and interactions between variables on its own.
- Produces a feature-importance output showing how useful each variable was across the splits.
- Serves as the building block of stronger ensemble methods such as random forests and gradient boosting.
Disadvantages of decision trees:
- They are unstable, meaning that a small change in the data can lead to a large change in the structure of the optimal decision tree.
- They are often relatively inaccurate. Many other predictors perform better with similar data. This can be remedied by replacing a single decision tree with a random forest, but a random forest is not as easy to interpret as a single decision tree.
- For data including categorical variables with different numbers of levels, information gain in decision trees is biased in favor of attributes with more levels.
- Calculations can become very complex, particularly if many values are uncertain or many outcomes are linked.
1. Classification Metrics (Measuring Homogeneity)
In classification trees, two main metrics are used to measure how "mixed" (impure) the data in a node is:
A. Gini Impurity
Gini impurity measures the probability that a randomly chosen element is misclassified. Our goal is to find the split that minimizes Gini impurity.
In a node, where the proportion of class j is pj — the Gini impurity IG is calculated as follows:
- C: Total number of classes.
- Goal: After a node is split, minimize the weighted average of the child nodes' values. The closer is to zero (0), the purer (more homogeneous) the node.
B. Entropy and Information Gain
Entropy is a measure of randomness or disorder (lack of information) in a system. The higher the entropy, the more mixed the data.
Information Gain (IG) measures the decrease in entropy resulting from a split. The algorithm selects the feature and split point that provide the highest information gain (i.e. the largest decrease in entropy).
- : Entropy of the node before the split.
- : Weighted entropy of the child nodes after the split.
2. Regression Metrics
In regression trees, the goal is to predict a continuous value rather than a class label, so homogeneity (purity) is measured by how well the predicted value represents the samples.
The main metric used is Mean Squared Error (MSE) or variance reduction. The algorithm chooses the split that minimizes the variance in the child nodes.
A node's MSE is calculated from the squared deviations of its samples from their mean value. The split is made using the feature and threshold that reduce the MSE the most for that node.
3. Overfitting and Pruning
The biggest academic challenge of decision trees is their tendency to overfit the training data. If a tree grows so deep that each leaf holds a single sample, it memorizes the training data perfectly but performs poorly on new, unseen data.
To prevent this, Pruning techniques are used:
- Pre-pruning: Stops the tree from growing when the number of samples in a node falls below a threshold or when the information gain after a split is very low.
- Post-pruning: After a fully grown tree is built, it cuts back nodes to improve its ability to generalize. An example of this is Cost-Complexity Pruning (a commonly used method).
These mathematical and statistical foundations show why decision trees are a powerful foundational algorithm.